|
机器之心报道
' | a' o' s& l, K5 | B7 H参与:杜伟、张倩前几天,OpenAI 发布了 7.74 亿参数量的新一版 GPT-2,并表示将在几个月之内发布 15.58 亿参数量的完整版本。但还没等到完整版官宣,有人就已经等不及了,索性自己动手复制了一个 15 亿参数量的 GPT-2,并将其命名为 OpenGPT-2。项目作者是来自布朗大学的两位硕士研究生,他们复制 GPT-2 的花费大约是 5 万美元。 9 P, c9 c7 S) P# ?
4 W) N; I' Y( C3 o! c
项目的两位作者:Aaron Gokaslan 和 Vanya Cohen 。' C/ e& H& Z+ d3 b5 u
读者可以在 Google Colab 上访问该模型并生成文本。
% @7 \% {) q6 o ]! B! pGoogle Colab 地址:https://colab.research.google.com/drive/1esbpDOorf7DQJV8GXWON24c-EQrSKOit" {$ x: l1 U9 F0 h
# }: U# |5 s( P, z& b
模型权重:https://drive.google.com/drive/u/0/folders/1KfK5MXtvgH8C615UUZoKPIUVJYIdJxX1, K; c: P; Z3 _( B$ a9 l8 l: B
作者表示,复制 GPT-2 没有那么难,论文中的很多结果都是他们两人可以复制的,并且二人并没有语言建模的经验。所以,只要你感兴趣(壕),你也能自己复制一份。
5 \% @% ^. S, @2 g
& x v- r" d- c; H: ~/ ]$ V' B4 u* c' N; r* a
复制方法和成本
# Z* g& b G/ u( e5 e! J1 S/ v/ q2 q
OpenGPT-2 的实现基于 Grover 模型,通过修改它们的代码库来达到 GPT-2 的语言建模训练目标。由于 Grover 模型是在类似的大型语料库上进行训练,所以很多代码和超参数很容易重复使用。他们也没有对 Grover 的超参数进行大量修改。
, Z% k0 s+ D4 K8 i X) f; g3 e
: z4 E. E: d1 t7 |" w至于成本嘛,他们使用自己的代码从零开始训练 GPT-2 模型大约花费了 5 万美元。但需要注意的是,5 万美元只是云计算的估算成本,没有包含更细微的内在成本(在其他效率更低的易用计算资源上训练模型的效果会更差)。5 w9 D* V. `0 Y# Q9 B" @9 L
! {6 l$ m* o8 [# i5 t3 x
数据集. U" Y$ v( b2 Q X( N
6 H( y, q4 y% M' S+ g" o
OpenAI GPT-2 的原始论文中有对清理数据集的详解。在该论文中,Open AI 的研究人员用到了一个名为 WebText 的数据集,其中包含数百万个网页。& |% F% D$ S" k* n( s6 P1 }) ?1 [
* [( C& x; G* E* X" i
论文地址:https://d4mucfpksywv.cloudfront.net/better-language-models/language_models_are_unsupervised_multitask_learners.pdf) u* {) h& O0 Q0 Z: U# ]
# R) i/ I+ y4 ]如 WebText 一样,本文中的两位研究者首先解析 Reddit 上 3 个 up-vote 以上的所有链接。同时,他们利用了 Pushshift Reddit scrape 数据集,该数据集集合了持续更新的 Reddit 帖子、评论和有关元数据。然后,作者对这些链接进行过滤,删除那些不太可能包含有用文本或 HTML 的文件类型(即视频文件、PDF 和 CSS 格式文件)的直接链接。
( N' p9 v" V* G: C1 C7 H% U- o5 C! @9 L/ A: Z
此外,作者还过滤了网页,以删除被各种评估基准和数据集所使用的 Wikipedia 内容。他们并不能确定自己的过滤方法是否符合 OpenAI 的标准。因此,他们使用 Newspaper Python 库从 HTML 网页上提取文本,然后使用 fastText Python 库只过滤掉英文文本。0 ?8 U6 P6 C5 t$ r( z: g' `
, ]- ?" S! f! L" O具体来说,作者使用了 WhatTheLang python Wrapper。他们利用局部敏感哈希(locally sensitive hashing,LSH)删除这些文档。最后,他们将这些文档散列到了 5-gram 的集合中,并删除了相似度阈值大于 0.5 的所有文档。
8 _# u' \: R* S0 c: [; E
d0 b' z6 f# b% \ Z0 c6 H作者还从数据集中删除了 token 数少于 128 的文档。这些短文档往往质量较低。作者将这一数据集作为 OpenWebTextCorpus 发布。
, G7 v% A1 A1 z, i3 M5 _+ g/ |2 d
数据集链接:https://skylion007.github.io/OpenWebTextCorpus/( ?: v* y' P( e7 r# P/ U
5 M2 Q$ W6 z+ j' e7 v/ k* h2 \
在编码数据集时,作者使用了 Radford 等人发布的适用于小模型的 Binary Pattern 编码器。他们还利用 OpenWebText 网页爬取代码库的修订版作为自身数据集集合的起始点。
% B# s7 W7 e& V% z" R, C2 X
: M* x; h2 X* X8 v9 f- ]4 i4 J" D从公开发布的 WebText 的 26 万篇文档的集合来看,作者发现所有文档的双字节编码(BPE)长度最小为 40,最大为 1024。而 OpenWebText 的不同之处在于作者将文档长度的最低值设为 128 个 token(替代 BPE),并且不限制文档最大长度。此外,原始 WebTextCorpus 是在这些样本可用之前发布的,因此作者没有使用这些信息来生成清理启发式。
9 h3 W+ g0 G2 M
W7 c6 r; e% x. m5 i尽管在训练分布上存在差异,作者依然得出了与多数数据集接近的困惑度。
8 N7 _8 G& t2 @' t1 ^9 g5 q4 ]7 s" E9 p) O4 R
`- Q, X5 r8 S5 M
效果
9 P5 J) K* L9 u4 L- @7 {# C0 ?1 z# C/ B1 U2 ^
两位作者在 medium 博客中展示了 OpenGPT-2 的生成效果。他们提供给模型的提示为:「Recycling is good for the world. NO! YOU COULD NOT BE MORE WRONG!!」,输入模型之后得到了以下输出:/ j. k# l- C% @5 `4 |
* W5 ^3 f; [& K1 Z/ e. Z! e. f/ Z4 X- ^9 b
( y$ n* {/ S- G, U6 r4 `" {! j. dreddit 网友也根据作者给出的连接进行了测试,并将测试结果与 OpenAI 前几天公布的 7.74 亿参数量版本进行了对比。有人表示:: R, K2 E$ R+ M4 L" t
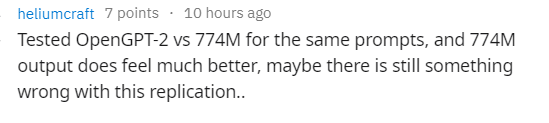 我使用相同的提示分别测试了 OpenGPT-2 和 OpenAI 的 GPT-2 7.74 亿参数版本,结果还是 OpenAI 的输出效果更好,所以作者的复制过程或许存在一些问题。 8 e8 D# g. B. o5 {! w( l
1 |; ]9 p0 i Q- q6 F' J/ @2 ]6 I- C0 l1 E
当然,也有人认为 OpenGPT-2 的效果更好:# I- ^ I5 H$ v$ @) c4 o$ a$ b/ N+ L
8 c0 f0 d$ Y0 ^. l4 n' f4 r" n
3 y/ j$ \" T7 `$ k# k O0 _我认为作者的 OpenGPT-2 效果优于 OpenAI 的 GPT-2 7.74 亿参数版本,但还不足以用来制造令人信服的假新闻。几次尝试输入「Shocking revelation! Vladimir Putin and Donald Trump are」,我得出了以下效果最佳的文本。该文本能够更长时间地保持语义连贯性,语句也更有意义,但还是比较容易被识破。但不可否认,OpenGPT-2 对研究确实很有帮助。
E& A; f6 Q9 S3 `# x& [9 h& R
U. s {! w; W$ P9 v但我还有一个疑问,OpenGPT-2 到底只是把它读过的文本随机组合到一起,还是真正地创造出了新文本。
$ ~7 _( J: J. n+ t6 g- Y
: D, }, W' Y$ h5 [ H- ?: c6 p: v- G! H+ t& @
( \7 C& l* ~+ j8 x/ A3 J; B0 a
至于 OpenGPT-2 的生成效果究竟如何,大家可以根据文中提供的链接测试一下。
/ _) J& _% w Z+ d% n1 x5 P9 B/ {' W5 N( o9 I: B
参考链接:
" w. v) r- z9 P' |) ?& X0 v" m( @
4 A7 U$ b5 k- O
: c2 `; P% k. b4 Q& r h+ m/ S1 u, w, @5 N
https://www.reddit.com/r/MachineLearning/comments/cu9xgi/p_opengpt2_we_replicated_gpt2_because_you_can_too/
5 ~4 g; F6 @. t+ a, ]% Chttps://medium.com/@vanya_cohen/opengpt-2-we-replicated-gpt-2-because-you-can-too-45e34e6d36dc
: ^7 p( N, k- f3 }3 T& M4 t+ q
$ E2 Y* [6 m" o. w& I( P4 ^) Y4 Z2 h2 I. e
* d) b" z6 [/ A! F/ R4 r' f" bWAIC 2019 开发者日 将于 8 月 31 日在上海世博中心举办,包含 1 个主单元、4 个分单元、黑客马拉松比赛和开发者诊所互动区。
2 V# G3 y t r
+ M, p6 |0 w* _+ `届时,全球顶尖 AI 专家、技术大牛、知名企业代表以及数千名开发者将齐聚上海,围绕人工智能前沿理论技术和开发实践进行分享与解读。 ' I5 |9 p# R: k$ Z5 S- o
点击阅读原文,立即报名。 ; \8 x/ r1 V# W( w' P# u# T. v
+ a0 V, e* ^7 _* l9 ]0 W! [
9 E7 ~# [% L( i {& a7 U
来源:http://mp.weixin.qq.com/s?src=11×tamp=1566630003&ver=1809&signature=lixpkgck3Jci-PJs9nuYQ2-e-AoYyRsK9T2JfY8UTHbrfqeLiSdjvkGmvntU-OVvGe8*llf7XPaBdBKSdmrL7CrALKS1LX-KQs*HOTH8twOu5W3TN*s6mdYxiqgYsckc&new=15 ~. U7 B M' x, C& O5 g
免责声明:如果侵犯了您的权益,请联系站长,我们会及时删除侵权内容,谢谢合作! |  |手机版|小黑屋|梦想之都-俊月星空
( 粤ICP备18056059号 )|网站地图


 发表于 2019-8-24 15:03:59

