|
机器之心报道
2 T) @4 v ?# c机器之心编辑部「DeepNumPy 可以写深度模型,且与经典 NumPy 100% 兼容」,AWS 副总裁 Smola 说,「深度图学习本领强大,Transformer 也可以分解为图」。「Julia 内建可微分编程,定义任何函数,他就会自动算出值以及梯度!」,Julia 创始人 Viral 说。这就是 WAIC 开发者日,属于开发者的节日。 7 K/ t/ G3 Z6 H; b7 Y2 a+ w. I
/ u; v, X% n( a9 g0 _7 [1 L. ^: u& B
WAIC 世界人工智能大会已于近日在上海开幕。在昨天由机器之心承办的开发者日主单元上,阿里技术副总裁贾扬清、亚马逊机器学习副总裁 Alex Smola、百度 AI 技术平台体系执行总监吴甜、Julia 创始人 Viral、Skymind 联合创始人 Adam Gibson 做了精彩演讲。$ F ]9 h' p+ Z% b" p4 u+ I6 O5 ^/ x
" U- }' C9 h( L- `/ x% v7 f0 g
& G" X4 x) I5 W3 n% C: T阿里贾扬清:从 20 瓦到 20 兆瓦的大脑1 q0 Z& `1 d1 s- J' O" P* d8 @
' B+ G9 f/ Z& |) l6 Y9 T# F2 i' F# \3 j6 b3 u I
; R' a8 o. s1 j C2 k0 y3 P9 D! ]
从 20 瓦的人脑到 20 兆瓦的云智能,近年来,随着算力、算法、数据的蓬勃发展,机器学习的基础设施也完善了起来。在 WAIC 开发者日中,贾扬清第一个分享了他这几年在人工智能领域的一些探索和想法。" p7 e& \. F: h
5 u( Y& R* y2 \; M3 X
6 w u$ \6 O2 j9 k0 a/ `' B( o7 C. e
* [3 o; I& l5 v. Y9 s; v
, i. G8 ^9 d) U& [3 d6 i; V$ L* _4 K4 J# ^/ Z# r# V; @
贾扬清是知名的人工智能青年学者,在加入阿里巴巴之前,他曾任 Facebook AI 架构部门总监,负责前沿 AI 平台的开发。在深度学习研究、工程、框架等诸多方面,贾扬清有众多为人所熟知的工作。今年 3 月,贾扬清正式宣布加入阿里巴巴,担任技术副总裁岗位,领导大数据计算平台的研发工作。
l" A, t4 Q9 r y& f' A$ B* E4 ?0 |9 U! U& g% \8 J
7 C" ^/ V* P5 A
在第一场分享中,贾扬清以《20 瓦,64 千瓦和 20 兆瓦的大脑》为题,从算法的潜力提升、算力的重要地位、数据的爆发式增长三方面讨论了这些年的 AI 发展,并最终表示「结合三者,云是 AI 的必然形式」。% x, ?! L9 O, ? ?6 K
3 z" X6 k( ^$ P& @$ i
) W1 N1 W, E) D; R0 Q! }/ x& @) U什么是算法的潜力
% G, {: M, c# e4 @+ F! `
$ @! u: q1 \) `' E8 p$ X4 k2 }6 f2 S* | o) l( {0 e- [
人类大脑功率大约 20W,那么都能做些什么呢?这包括与环境交互、学习、推理等等。但是人工智能模拟起来却非常难,贾扬清最开始从经典机器学习算法讲到当前主流的算法,回顾了这些年算法潜力的变迁。举个简单的例子,机器学习需要图像特征,那么最开始是通过 HOG 获取简单的特征,后来发现「边缘」可能非常重要,因此各种卷积神经网络也就大显身手了。+ p: Z& J0 T5 P/ b$ }+ d) }- h, i$ U
5 }. T) W& r. |4 S
* A7 a: Y1 l1 X. \7 C3 r
深度神经网络大大提升了算法的潜力,贾扬清举了个案例,在 ImageNet 图像识别挑战赛中,最开始 SVM 等经典算法已经到头了,但那时它们的潜力也只能支持达到 25% 的错误率。但随着 AlexNet 的提出,错误率瞬间就降到了 15%,而且重要的是,这种方法有很大的潜力,之后的研究使 ImageNet 的错误率一直在降低,甚至低于「人类」识别错误率 5%。
' s) N9 j2 c3 Q9 r$ ]2 n
$ ]; I8 G( e' v
- w0 Z9 c/ N' b: ?, M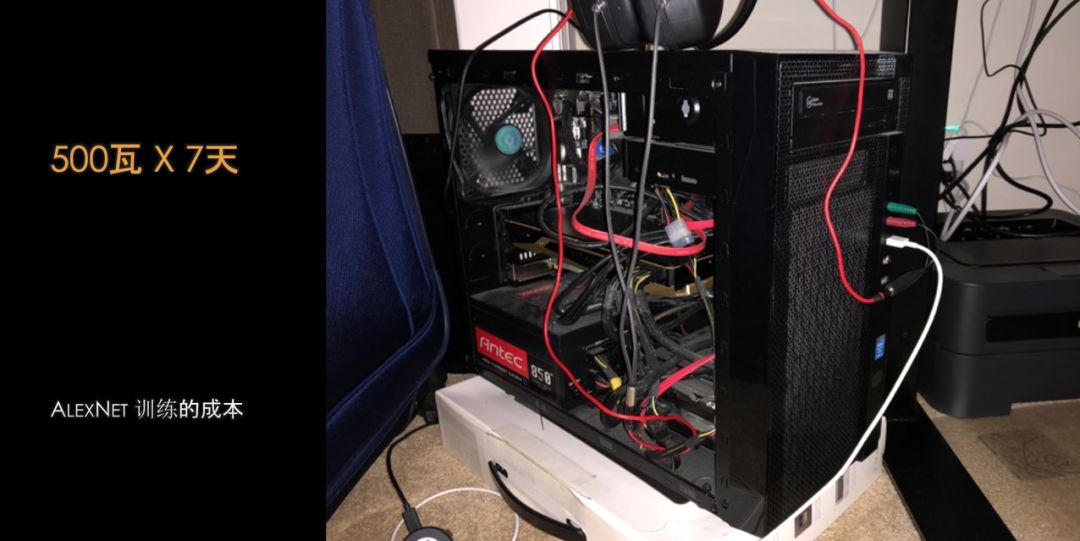 * M4 n& z' |1 I: F6 ]* N! k9 Z- V1 @
( h4 l/ _5 ~& x; r4 I$ F1 T
" M& z/ f- `9 R深度学习利用强大的拟合能力大大扩展了算法潜力,现在算法问题已经解决了,那么算力问题呢,我们该怎样利用计算系统提升训练速度?
, m N. ]1 E% J4 V9 |
* i( d% A, R. P) q: x) z' i( H3 p' a p4 I1 T5 e3 E; j
为什么需要算力、数据
. J5 i8 \4 |3 U
- T3 h+ W% }9 j9 V$ z( f
0 {3 P7 m" A' N1 ~( q人脑的计算速度是有限的,但计算机可以通过堆算力来提高计算机系统或机器学习系统的能力。在这方面,人们一直在研究如何通过系统的方法提高训练速度。) L7 o A# |. i
0 b, x2 t) ^. k1 h* L: P! r! h
* x3 V$ f( ~4 l5 p6 d" b- A7 |" @, i: \
2014 年,机器识别一张图片里的内容要花 13 微秒左右,但今天,这一速度已提升了上百倍甚至上千倍。这一提升得益于 GPU 的聚合:单个 GPU 每秒只能处理 230 张图像,比人快不了多少,但 256 个 GPU 聚合在一起却可以处理 6 万张图像。因此,我们可以通过大量堆算力的方式来提高训练速度,这也是大家前几年不断努力做的一件事情。而这些 GPU 又通过分布式训练的方式进行合作。0 v/ N" |& `! P p5 a, \9 _
% g! ~) t6 H' H4 u+ e
5 k$ l5 \$ }6 Y/ ?0 c4 g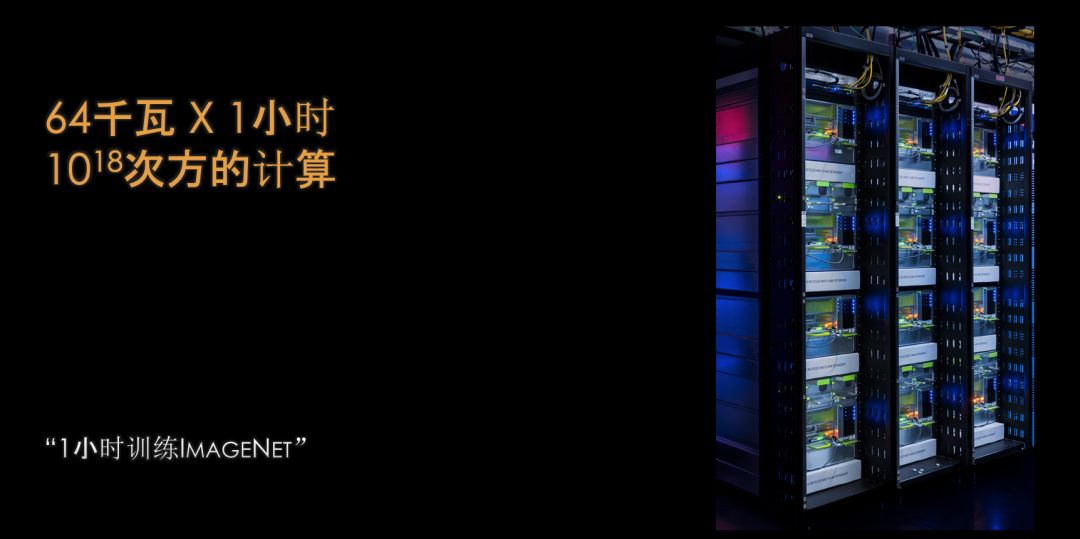
6 S( R9 D# M& d3 a- U/ s4 {" E$ L( L4 L+ h' Q ^" g
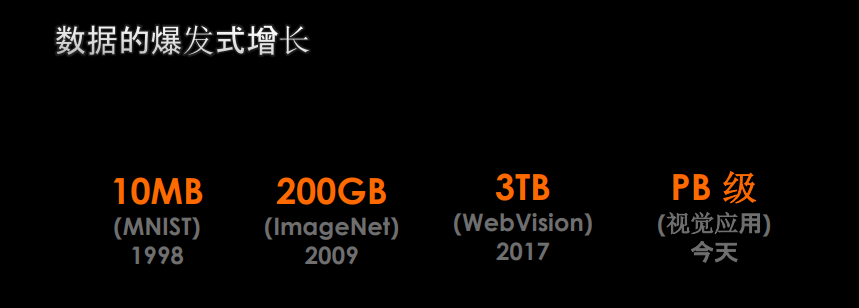
; v" z. ` }' ]$ B& K2 d! Q ~; y如果说算法是潜在的能力,那么算力就是发挥潜力的保证。但是,算力将训练速度提升之后,模型的复杂度也随之提高。而模型越复杂,过拟合的可能性也就越大,因此我们还需要更多的数据来缓解过拟合。
- r, h& C3 F7 z1 q$ X
, b% o- ^/ e# z
5 @8 l5 F2 Q- X: r- g( t从 1989 年至今,训练模型所需的数据量也经历了爆炸式增长,从 MB 到 GB,再到 TB 和 PB。
* `9 G; b! u o
# z8 `* x( ]; R% H# ?1 q( g2 O2 E; t1 B+ f4 b& S+ g* h
) |# _6 J0 o" e2 v5 C5 c% O3 ~; ~+ b! U9 G+ C) o; Q" ~
, z0 d# n! i7 _0 O20 兆瓦的大脑
% n+ s# R- W* S
6 ^& R# ~4 M2 {8 ?. {0 f3 p+ H/ [6 o# P3 ~$ t: b+ a: }8 l
有了高效的算法、海量的数据和庞大的算力,那么怎样才能将它们聚合在一起并应用到实际业务中呢?贾扬清表示,很多科技巨头都是通过云的方式来解决,也就是通过 20 兆瓦的大脑解决。
& V9 j+ W, K3 U% O0 V# d
& Q8 ]1 }; `; V4 V2 ~0 F7 R$ u
2 a% l+ K7 _2 f6 b+ n y2 ]6 z贾扬清说:「为什么我们说只有通过云这种模式,才能够实现机器学习的创新?是因为云向我们提供了更大的规模、更高的可用性、更强大的安全性。」
3 k( q) q+ d1 J( S' g6 `( L8 q& U$ U$ g1 _1 Q. G
" o9 G3 e. l% W S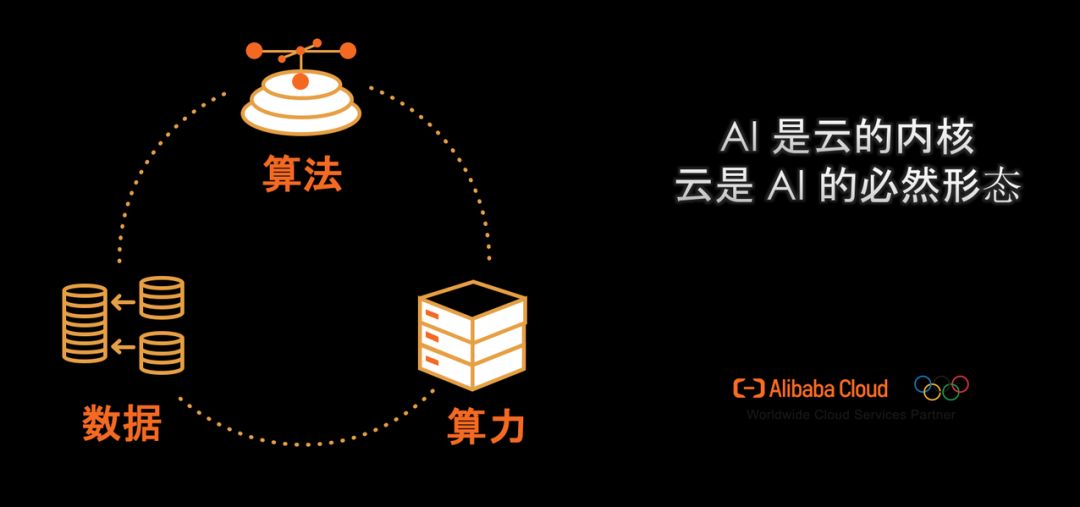
4 I8 r* {8 U# w4 D1 }1 d. L: O7 X# y
# {7 f& c6 M8 J% f+ [( v: G- ?8 e2 _3 R
此外对于公司来说,我们关注的应该是业务,而不是基础架构这些东西,所以云能很好地解决这些问题。贾扬清说:「从 20 瓦的大脑到 20 兆瓦的大脑,我非常高兴的是我们一直在解决各种问题,希望联合算力、算法和数据,从而不断趋近于真正的智能。」
, `( f K6 z4 s1 f, Q! I+ X5 m8 m/ f9 f' ^! _6 g
: `7 H7 b9 I1 V) f9 N! x「AI 与云的结合是一条必经之路」,贾扬清总结道,「我从一个研究者开始逐渐转向了工程、转向了业务、转向了更宽的思考范围,从而将 AI 向前推动地更远,这是我非常兴奋的一点。」9 p- u' Y8 o, a' N: d% \) B5 }
2 V& Y% i$ T& |# C- k
1 z+ F. D" m* l) g' H亚马逊 Alex Smola:深度 NumPy 与深度图学习 % L% V/ ~. P% a4 K; n; e5 ?
5 s& S: W g! E2 o! W0 H+ `
; p- O* Q0 L8 Q0 {7 r& W2 o! `) CNumPy 差不多是所有机器学习开发者必须了解的库,它为 Python 附上了数值计算的「灵魂」。然而随着深度学习框架的流行,NumPy 似乎已经不再闪耀。那么我们是不是能为 NumPy 插上「Deep」的翅膀,用 NumPy 的 API 直接构建并训练深度模型?这就是 Alex Smola 为我们介绍的 DeepNumPy。% |2 \" J I7 W; s
! f( W: z4 {; P. E) u5 k
3 Q- ^7 E% V/ V7 L' _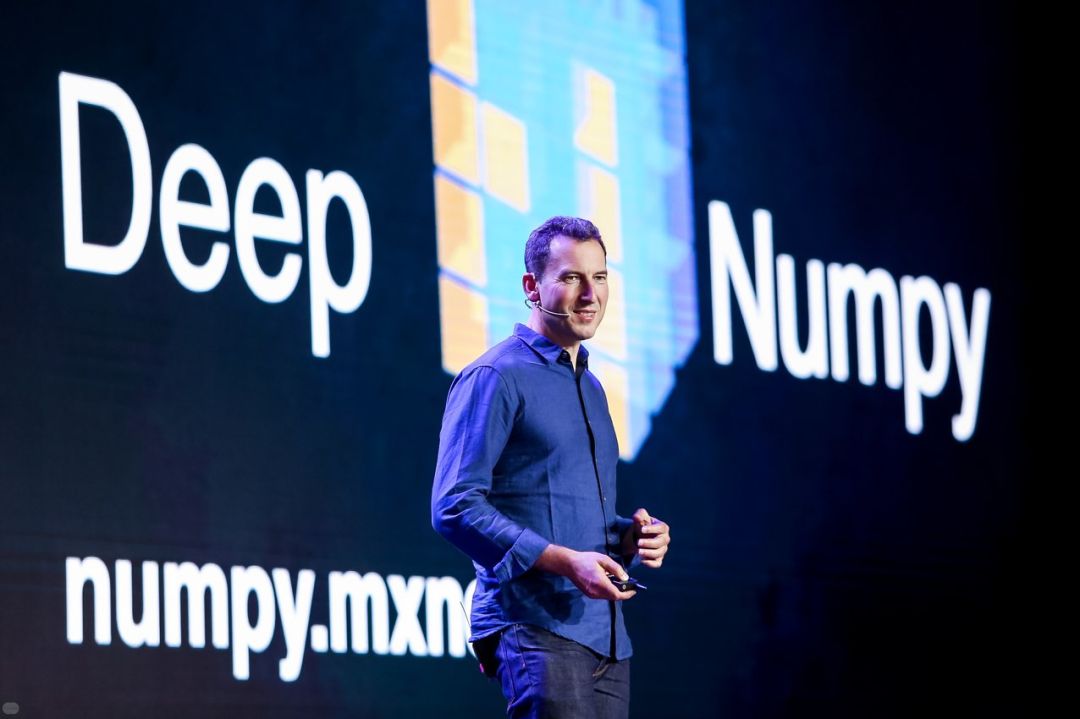 " p# E! `; i* g; f8 ]
' b# B& U g. B" X2 ^
) O9 Z5 a( i) R0 V
除此之外,Alex Smola 在开发者日上还重点介绍了图神经网络框架 DGL,它与 DeepNumPy 共同为开发者提供最好用的工具与 API。
1 Q M8 H) C6 r4 A7 C3 |8 S3 y1 l( [: q) o, C# U
+ \2 @) d4 _* a7 XAlex Smola 于 2016 年 8 月加入 AWS,现在是 AWS 副总裁和杰出科学家。Smola 被公认为世界顶级机器学习专家之一,他在 2013 年加入 CMU,并担任教授。Alex 是学术研究界的一位多产且被广泛引用的作者,撰写或贡献了近 500 篇论文,引用量达 75000 多次。
$ `# x( B& \% X# c: e! ^& A' { ~9 R# r! m/ W/ A4 s/ n! d
& _, b3 H( m2 t7 F6 f下面,让我们看看 Smola 大神在 WAIC 开发者日上介绍的《Deep NumPy and DGL》都有什么吧。
5 |) i5 \+ N4 J9 D3 I; h) v* i+ D& t/ Y5 Q% g0 H/ R; Z7 o& d
( }0 W8 H0 _& f9 H
DeepNumPy
r8 k! ]& z( x$ U
6 X/ k5 Q4 ?. i; C% z4 } C5 d8 T6 J1 t' Q
Smola 先让我们思考思考,到底机器学习的开发流程是什么样的?这时候我们就会发现 NumPy 即使在深度学习时代,也有非常多的应用。我们习惯了在预处理时使用 NumPy,在预测和可视化时使用 NumPy,甚至在不同模块间传递张量也用 NumPy。除了核心的模型搭建与训练,似乎其它流程都能用 NumPy。
2 d# B8 x0 m3 K! i1 s8 M' @4 @: U
! [1 J' _+ h8 P$ k' K% [1 x; [
" c1 x' A. x7 k K1 J& r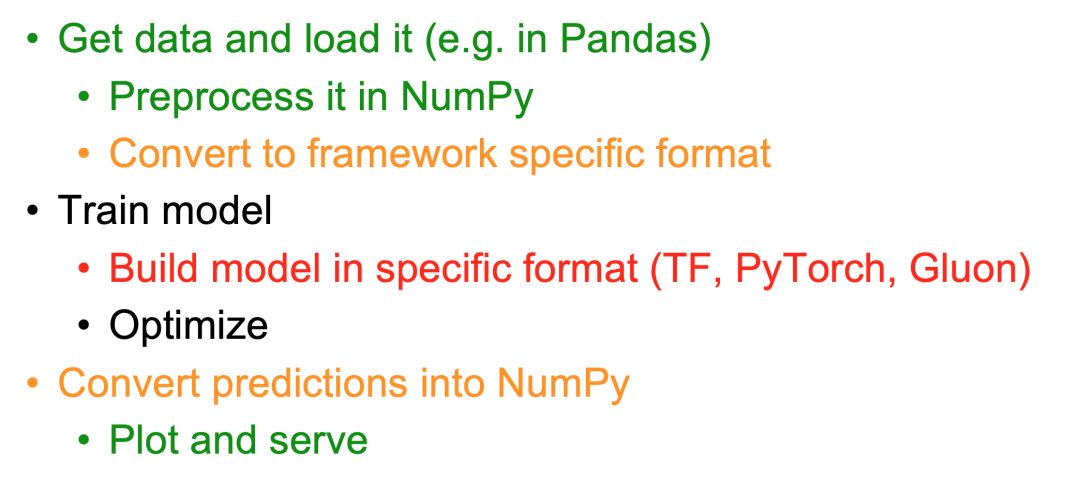 ( e# |+ m: }8 d& a+ ?- a) L
: T8 t3 h8 X/ v) n
. b" b1 B# [$ G5 q _. j那么 NumPy 既然在矩阵运算、数据处理等需要 CPU 的环境下如此强大,我们为什么不直接将它迁移到 GPU,并赋予神经网络 API、自动微分等能力,这样不更方便么?Smola 表示,MXNet 社区正在做这样的事,希望构建和 NumPy 100% 兼容且还能搭建神经网络的工具。
+ y1 m" q4 c3 N* h p- V: X0 n1 x/ N3 X, e! V) C* {* U) I
+ p% L- T; i- J- ]. E% [ ]# E5 C- r3 j2 S+ D) }- o6 _) O
9 q" N6 E* B% j. n9 s3 a' I
简单而言,DeepNumPy 作为 MXNet 的前端,它提供了类似 NumPy 的接口,且包含了一系列用于扩展深度学习能力的模块。DeepNumPy 主要包含两大部分,即 mxnet.np 和 mxnet.npx,其中第一部分用起来和 NumPy 是一样的,第二部分会提供更多扩展运算符,对深度学习更有优势。
6 X3 J5 y' [7 r$ C/ N3 N: }9 h( |6 I7 [5 m
* f( S8 W) m0 A% a' Q如下 Smola 在开发者日中主要介绍了 DeepNumPy 的两大特点,即异步执行与自动并行化。异步执行的优势与过程如下图所示:. H! q2 ~9 {( F/ L) h
! n$ X; [* L8 O. o0 O* i X
! e' o9 m/ i+ a. M' d% K3 u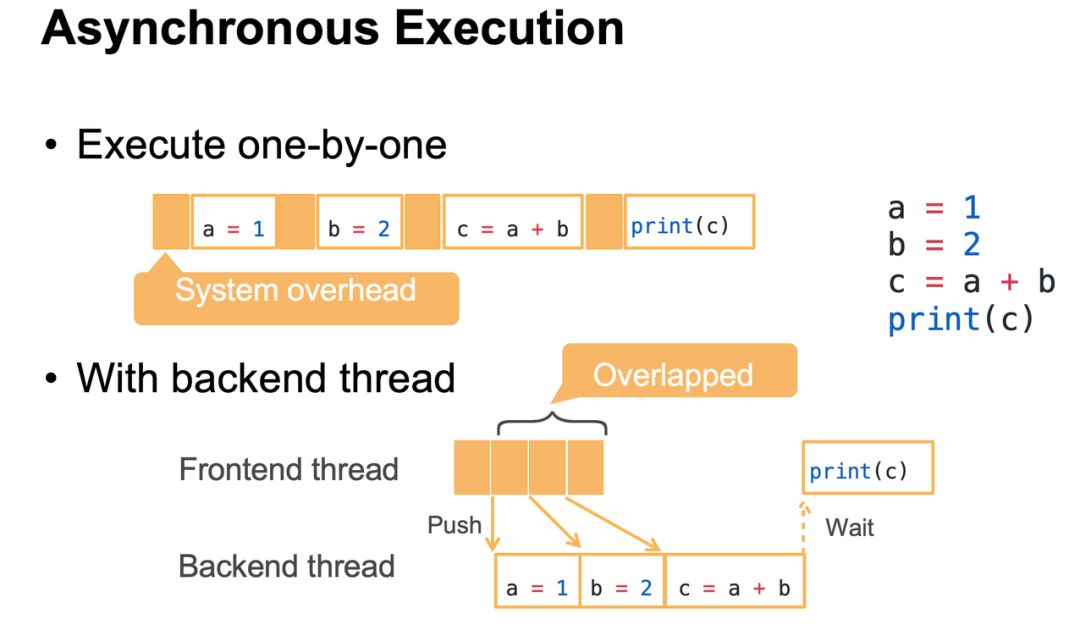 3 N# K/ N$ ~/ O. ]! x% C6 {+ h
1 M0 p9 x+ h& P' E' v
2 L: \# m3 d V2 i; K- h一般而言,我们写的语句是一行行执行的,且系统的成本也会和真实运行加在一起。DeepNumPy 的优势在于,后端会以异步的形式处理前端运算。3 ]$ ?. p7 Q! n+ u6 M( ]
9 T$ s3 S! g f# Z
4 }$ Q' z; h% b# b" q) B- Z7 r
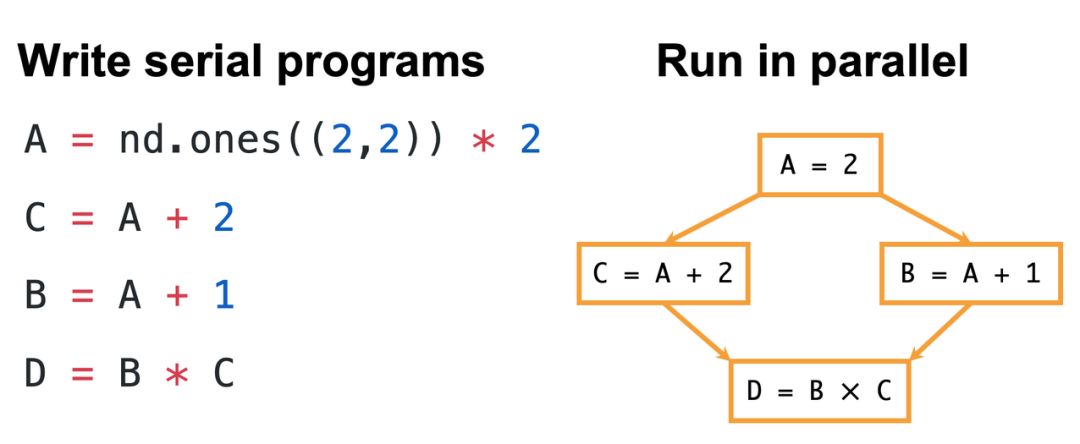
Smola 表示 DeepNumPy 另一个优势是自动并行化,它可以自动解析不同变量之间的依赖性关系,然后优化运行路径。如以下例子所示,即使我们写的是一行行代码,但 DeepNumPy 可以将 B 和 C 两个不相关的变量并行处理,从而大大降低了运行时间。
4 b7 X9 ^" q- l B4 e- S, M
8 U @, L- Q2 U \! o3 C/ ~+ ]' ?! ~& ]& G
5 g7 ?6 H. t: S' c- J- ^( T9 L+ P) q4 I* G
( E4 w4 i! L) |! T& B/ [
Smola 总结道,DeepNumPy 在 Apache 开源组织的管理下,将继续修改各种 Bug、提供更多强大的新特性。目前 DeepNumPy 已经在通过 TVM 优化 Operator,以提供更多的便利,包括支持 CPU、GPU 和 ASIC 等其它硬件。此外在性能上,DeepNumPy 经过 OP 融合与定制化的调度机制,它即使在大模型上也能展现出非常优异的性能。
$ i1 _3 y5 `3 ^* L) R: k0 a; e% A% G
0 s; }! s# D6 j在听过 Smola 的介绍后,机器之心也查看了这一前沿的开源工作,虽然目前 API 文档还没有完善,但从一些案例中,我们发现它的使用方法真的和 NumPy 一模一样,不论是创建数组,还是执行索引、运算等常规操作,都有一股熟悉的味道。. P. D6 C7 }7 Q
* q5 ~" b- c$ w0 N+ V T
' }& a0 E9 f* G8 x( ^5 d. @Deep Graph Library2 h8 d5 Q8 N( H+ w% ~7 ]( {; Z
0 i2 i' H/ P' x4 d) R! C7 g( y
' _9 C( F% Q; z% M( f H/ bSomola 另外重点介绍的就是深度图学习了,这也是近来非常受关注的研究方向。机器之心之前曾介绍过 AWS 开源的 DGL 库,那么现在让我们看看 Smola 眼中的深度图学习是什么样的。3 k4 \$ i- m, f8 ]! Z
2 z. k& P7 }4 K) ?- w) }6 h
" c+ a$ B8 V9 C首先 Smola 先定义了什么是图(Graph),以及它的一些应用,例如社交的推荐和欺诈检测等。图之所以这么重要,很大程度上在于它的表达能力,现实世界上很多数据都能用图来表示,差不多是最重要也是最通用的表示方法。然而深度神经网络擅长的是图像等非结构化数据,它基本上处理不了关系型数据,这就要求「图」算法有更新的发展。
& M5 x3 c7 V) P" a3 _/ \3 r* {7 k8 X9 p
# w5 A5 }8 m G. n; f6 t2 { * d0 [( B5 S4 r
* f& N; J3 s" F' _! d4 Q0 f1 Y
" z; ^' g, O4 oSmola 说:「DGL 是一个 Python 包,它为现存的张量数据库和图数据提供一个高效的接口。」为了完成这个目标,DGL 必须能兼容多个深度学习框架、必须提供最精简的 API,同时还要高效地并行图的计算。据 Smola 介绍,目前 DGL 已经支持图卷积网络和 TreeLSTM 等多种网络,也适用于很多应用场景。
k1 u0 m" ]# a0 m- ~- g8 O1 \- b9 @5 R) Q6 A$ N/ T
4 R# W. h* d1 U+ C* _' X* D; l2 J
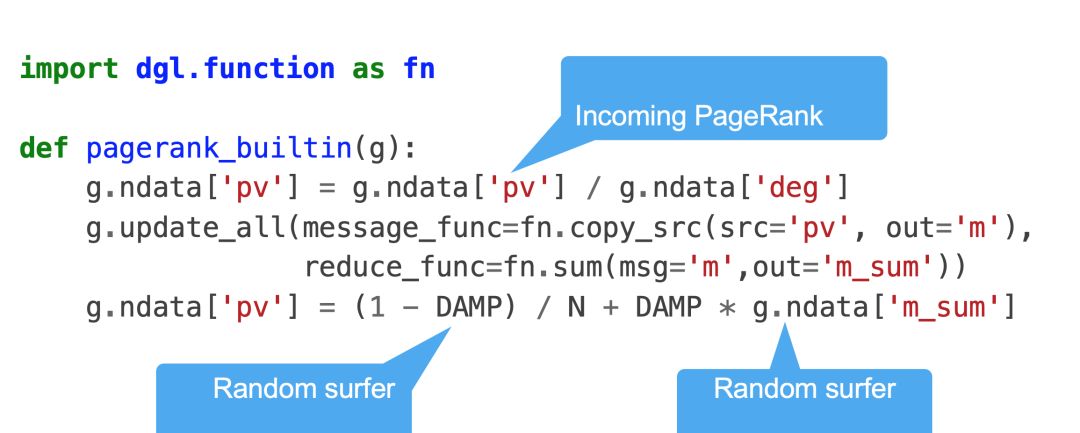
Smola 举了个 Pagerank 的案例,它最开始是一种对网页重要性进行排序的算法。Pagerank 本质上是一种以网页之间的超链接个数和质量作为主要因素的排序算法,因此,我们也可以将网页视为节点,超链接视为连接的边,这样就能构建一个标准的图。
; j1 n' I; Y4 R, N9 y; {6 _; ~# \& {+ \! x8 f
! l' c" c8 i7 [* e2 t4 l* H* u: f如下所示为 DGL 实现 Pagerank 的代码,它的构建过程非常简洁。
( Q: e" B8 C3 T+ f
, Y* x6 [" n( y7 ~* b$ ~$ P( {8 E! g8 A9 P+ o
 9 t% g. W; B; o, `/ \( }
w8 ?2 a/ Y6 p! P1 @
2 O: @; w& N& k
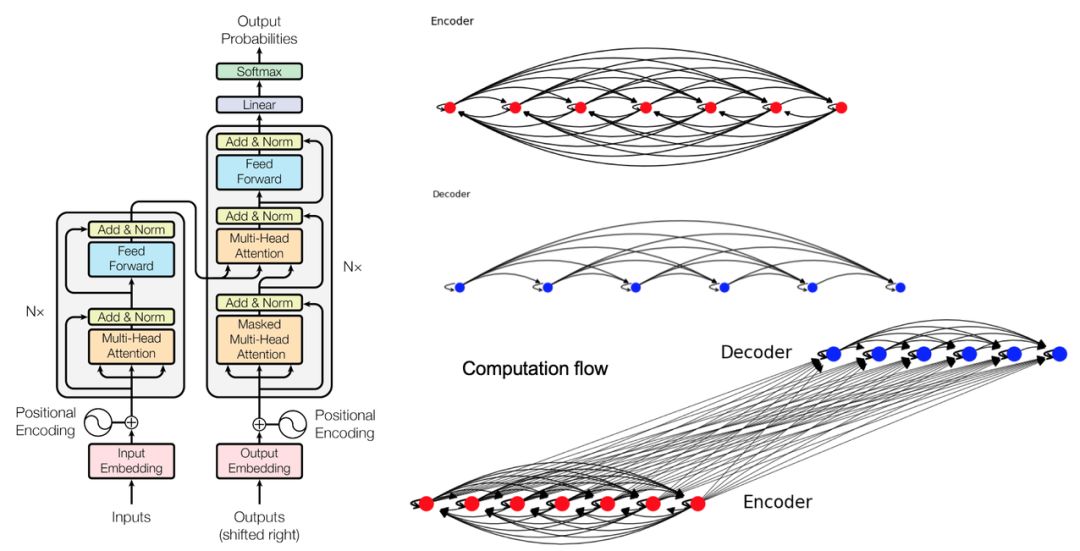
Smola 在现场还展示了更多用 DGL 建模复杂网络的案例,包括图卷积网络和 Tree-LSTM 等,其中非常有意思的是 Transformer,DGL 也可以将它分解为图,从而扩展它的能力。
" h/ F& E p' c9 ~- |1 V
l! x6 R5 K3 @$ E% Q1 W
) y7 z' z4 e9 ?8 s) q& U下图展示了 Transformer 如何解构为图,Smola 说:「我们可以将注意力视为图中的边,并采用边上的消息传递机制作为对应的运算过程,这样我们就可以将整个 Transformer 表示为图。具体而言,Transformer 可以由几个子图组成,其中 Encoder 建模的是原语言图,每一个 Token 即一个节点,不同节点间通过注意力进行连接。Decoder 也是一样,它建模的是目标语的图。」
4 i: }8 R) _5 N( u& U8 b) e+ ~/ @# e# A$ ]! ?
6 [) e: z" E& h
 ~. v+ d4 d2 [, d* x3 i
+ r7 }, X/ B. l1 s) o+ f( A( t# H* |9 u2 K# `' y
Smola 表示:「目标语的图是半完全的,也就是每一个词只能注意到已预测的历史词,它和原语言的完全图是不一样的。最后 Encoder 和 Decoder 相结合就能生成完整的 Transformer 图。」' O: ]% F4 w8 _; w: { n
. i5 U6 X' e+ T6 S V, @3 T& h) q0 h) B: ~+ U
总体而言,听过 Smola 的演讲后,我们感觉图的应用要远比想象中多得多。像图像或文本这些一般神经网络能很好处理的数据,图神经网络同样也可以,甚至计算上有更好的优势。6 r L2 A# i5 r/ B' ~+ F
U; F, u% ~$ q/ I
V$ I1 i1 f9 T& o百度吴甜:语言与知识技术产业应用创新与实践 # Y* z& K2 B$ O
. U, J7 A; B1 H; {
0 n9 ^/ _( I5 e* l$ b6 b
以技术落地为落脚点,在本次 WAIC 开发者日上,百度 AI 技术平台体系执行总监吴甜为我们带来了主题为《语言与知识技术产业应用创新与实践》的演讲。
+ G) Q! ^' k1 |2 |' S8 D' v$ ?) b* e5 k
( y6 W+ M0 L" W3 ~& T: H0 H; J
 " u8 Z) L x. h, `4 W) L/ I3 c
- {2 g) Z9 q& q) @$ G! A
9 Y; l( V' u4 { m" A6 r吴甜现为百度 AI 技术平台体系执行总监以及深度学习技术与应用国家工程实验室副主任。她主要负责百度自然语言处理、知识图谱、深度学习技术平台飞桨(PaddlePadddle)、百度大脑开放平台与生态等。
4 D. I* N# U/ P/ J7 L: o6 S+ a# D, Z! w
% `6 d6 h. E- ^9 S0 Z. ~
百度语言与知识技术布局、发展历程和开放场景
# g$ I% |/ n+ z* h, s' P6 E T% Y' h9 d" k
, Z6 ?: F# A2 ^! ]$ l
吴甜开始逐一介绍百度语言与知识技术布局,其中底层的知识图谱是基础,中间层是语言理解和语言生成,最上层则是智能搜索、深度问答、对话系统、智能创作和机器翻译五个应用领域。" b' m* z [7 r
! u- f, t$ a, [; k' R
% s8 |: S$ I0 {: D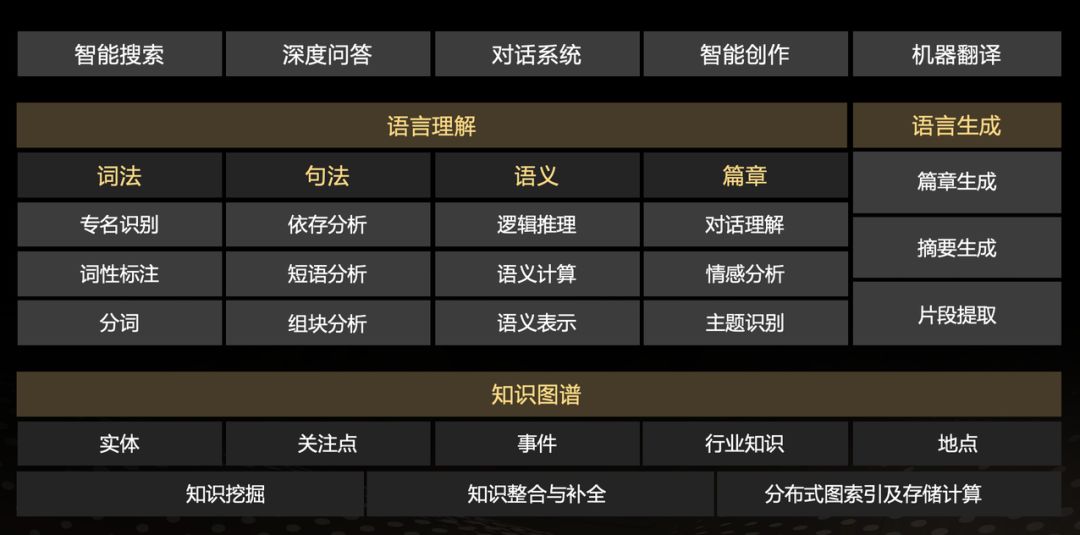
. O: w. D% C) s: D8 A8 ~7 w百度语言与知识技术布局。
& B/ n. P! U' X: s3 L+ x, M+ J/ }& l" n: k
" a* a: _7 O$ Y3 D; w4 u
这样完善的布局,它的发展也是有一些过程的,吴甜表示主要可以分为三个阶段:第一阶段始于 2000 年,主要集中于技术模块的集成;第二阶段始于 2014 年,开始将技术平台化;第三阶段始于 2017 年,开始开源开放大生产平台。
5 f/ m" f$ s4 j v, _* i) K. C1 K2 j. T
) n3 j! \$ O! O1 _. z0 d9 X. y [
7 \7 {, }; B0 X9 F那么百度大脑语言与知识技术开放全景究竟是怎样的呢?如下图所示,最底层是深度学习开源框架和平台 PaddlePaddle,倒数第二层是语言和知识领域的各项基础技术,往上是四个应用级平台,再往上是四种服务方式和各种场景方案。$ Y5 T7 V4 r" c. y2 A
" U5 w K) I9 x( @2 ^3 q
- \+ n. a. z& K8 \& A' }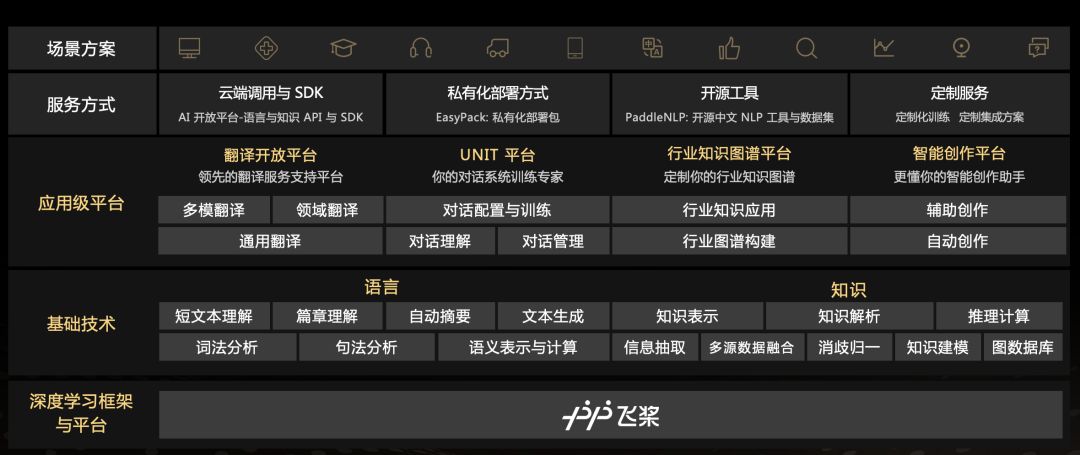 & j/ X& ~4 m8 G' r9 K) q7 b5 P# `
百度大脑语言与知识技术开放全景。
3 x% G4 R% B0 ^! A. G; g- B M: M. b8 J9 U$ l. z$ O- [
/ A" A4 }' z/ m' \1 h: m/ P3 f0 |
百度在 NLP 又有什么样的重要成果?
- ^' }9 W3 C1 r0 P7 z- D8 }1 x4 \% V' |0 p9 x# n, p" R7 k
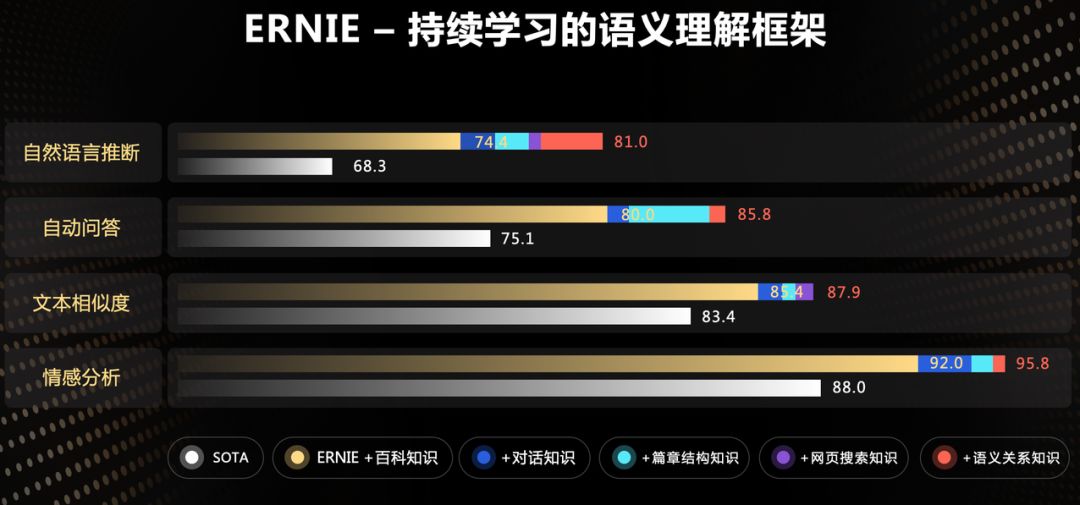
2 \8 _; V" I7 A/ z百度在自然语言处理领域的重要成果包括语义表示预训练模型和今年 7 月份推出的持续学习语义理解框架 ERNIE。吴甜表示,ERNIT 已经累积了 13 亿+知识,其中包括 1500 万篇百科语料和词语实体知识、10 亿条网页搜索知识、700 万轮人类对话数据、2000 万对句子语义关系和 3 亿组篇章结构关系。
. u. I& q( x+ b, l% R; i) Z% E$ d
I! q1 Z6 M/ }' w% A
 ' X) Y( ?- [8 D+ P& z2 F( O
持续学习的语义理解框架 ERNIE。 " R R% B2 ?5 V2 \3 e( U, y
9 l9 Y2 f* C0 C ?) h7 b! V0 a( {! N7 k& D
ERNIE 框架在工业应用上又有哪些效果呢?首先在智能问答场景中,如果将 ERNIE 模型应用于问题的分析和排序上,召回率就能提升了 7%;在加入 ERNIE 模型的情况下,广告的相关性也提升了 2.7%;ERNIE 模型能够使文本润色的准确率提升 7.3%;在对话理解场景中,ERNIE 模型将准确率也提升了 2%。
0 O E: n4 { [* o8 S! L. m* b+ S* p' I6 b& V
/ _( y$ @5 K) n, p$ cPaddlePaddle 深度学习平台
5 y2 E4 C" J1 ^$ w( j$ k) O+ X" `. X- X
( y J% I7 J4 n7 W但是要训练 ERNIE 这样的大模型,非常重要的一点就是提升训练速度。因此,百度推出了基于 PaddlePaddle 的 GPU 多机多卡训练加速,从而使得基于飞桨训练 ERNIE 模型多机加速比达到 77%。6 K8 E2 I" f1 a5 K4 G, L" l
, |2 r/ X; N8 K+ A8 l/ ^
5 k" Z& z; @3 O/ m$ \% u* Q+ }
PaddlePaddle 以深度学习框架为核心,从数据预处理到模型部署为深度学习的整个开发和应用流程提供了完整的工具。其中核心框架是从头构建模型的基础,而工具组建可以帮助我们快速训练与试验模型。最后的服务平台会为开发者提供整体流程支持。& ^6 h1 S0 p5 B- y& G# Y
8 \, V2 }, ]! J4 n
9 k/ e2 V5 z, _1 \; o3 e6 H) c( N. w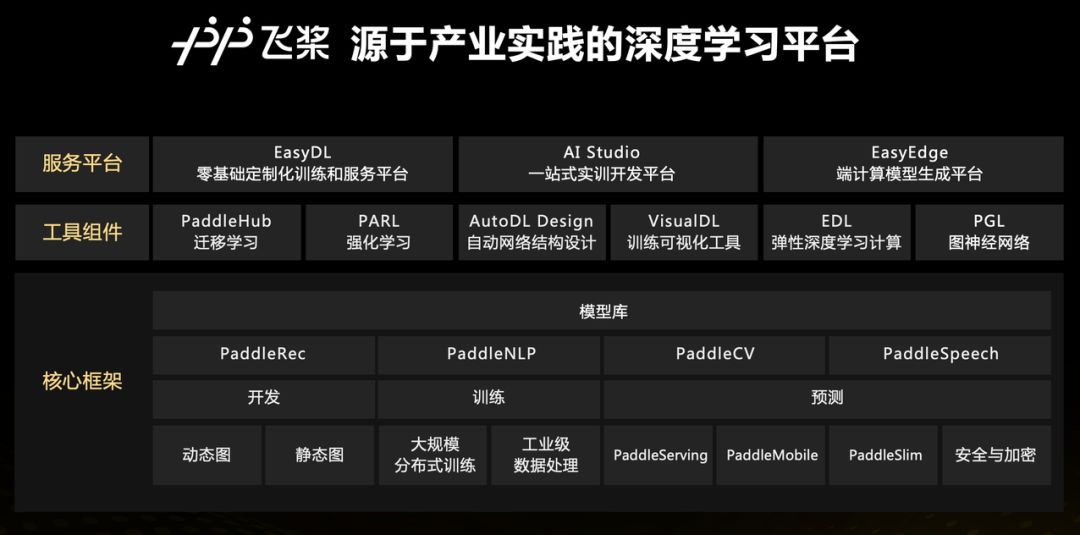 % g( K: @- Y0 W: C$ w! A$ u
! A. R8 U9 V0 s4 ]( X: f! o1 H( B. t e- W1 y& V, f+ T w
吴甜后面分别介绍了一键加载工业级预训练模型百度 PaddleHub 和面向工业应用的中文 NLP 开源数据集 PaddleNLP,后者提供共享工业级骨干代码,能够轻松适应领域需求。它们都是以飞桨为核心框架,并扩展它的能力。
0 ^ x# n0 S, V6 s$ h( h1 x" F- h9 s5 y4 @
- o; h5 v7 W7 z2 t+ l
在 DL 平台和基础技术之上,吴甜以 UNIT(理解与交互技术)平台为例,介绍了应用级平台智能便捷性。UNIT 平台致力于打造为对话系统定制的专业、低成本、全链路的技术与服务平台,并已经为金融、教育等行业提供解决方案和服务。
3 N+ \& a# _+ O4 K' t
! n: ]$ G0 A0 G. ]
5 x9 d. ]3 N! b2 e8 uUNIT 平台核心技术包括语义理解、阅读理解和对话管理三大部分,其中 ERNIE SLU 可达到在同样理解精度下标注量降低 37%~72%,DataKit 可使数据生产效率提升 8 倍,使用语义理解 SLU 定制可使对话技能综合研发成本降低 60%。目前,UNIT 平台已实现 6.8 万定制技能,累计交互次数达 570 亿次,全面覆盖智能客服、智能出行、智能办公及其他智能交互场景,为一线开发者实现 AI 产业化提供有力工具。+ d' _0 [9 R$ x7 B
0 }( [1 B: r( r# l( H& Q$ ]( U9 W
! |$ `; O/ P) H; @" `- e0 Y9 S+ Y总体而言,百度的语言与知识技术就是在飞桨深度学习平台上,搭建完善基础技术和应用平台,从而构建更强大的 AI 基础设施。 M- j: I7 l5 N8 r
# Q0 Z0 h% z0 W& a+ K
_0 S5 I, d: s; q8 M* ]9 f9 x
Julia 创始人 Viral B. Shah :天生支持可微分编程的 Julia ( _, r3 G' @7 X4 N$ T) E
. n' k% W7 N. K/ k
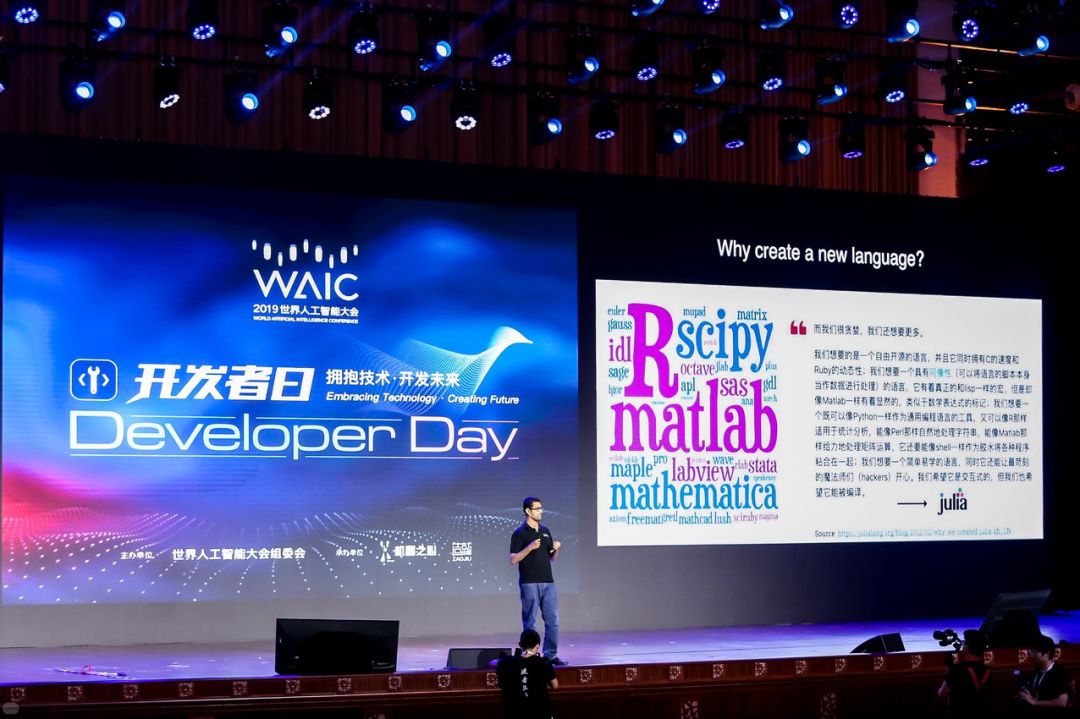
$ C- a, z' t& d) V* c. k7 l2 W去年 8 月份,MIT 正式发布了 Julia 1.0,在开发者社区引起了很大的轰动。该语言旨在结合 C 的速度、Matlab 的数学表征、Python 的通用编程与 Shell 的胶水命令行。那么,Julia 语言以后该怎样走?Viral 在开发者日表示,只有内嵌可微编程系统,Julia 才能更适合深度学习开发,适合更广的科学运算。
* u; _5 b8 u# b/ i9 W' b: d6 }, f% m& ~$ J5 E2 w* W# }
- G8 N# c" J& }' V1 d. P( d
 4 y. ?" J5 S+ S$ m
1 K0 w# ^2 P. k$ O/ ? i* a2 o7 w2 z8 h- p- N* \- q
在本次的开发者日上,作为 Julia 创始人之一的 Viral B. Shah 博士重点介绍了为什么 Julia 适合做机器学习开发,以及 Julia 在科学计算与机器学习上的可微分编程探索。这种机制将内嵌于 Julia 语言,且因为没有中间语言的转换,它做深度学习、做反向传播的速度还要快于 DL 框架。) m4 z2 ~$ r3 L, X
. `' f3 v, _( o5 z' u
8 U# F8 Q* o. v
Viral B. Shah 拥有加州大学圣巴巴拉分校的计算机科学博士学位。他是 Julia 语言的创始人之一、Julia Computing 的联合创始人兼首席执行官,也是开源程序 Circuitscape 的作者之一。
& W: q+ ~7 O* `+ s) b( |# |+ @2 u6 I$ Z
' O/ Q, s# O" ~ B* v5 Y2 w拥有如此多的研究和开发经验,Viral 在开发者日介绍的《Julia: Generalizing Deep Learning and AI with Differentiable Programming》一定很有意思。
% \) y% }0 o3 u* ^* v. r: \
# T$ M) F. i& G7 S9 Z
, e# _& k2 X1 a0 a为什么 DL 需要新语言8 ?8 A. p: u3 k8 @3 \( w0 f7 Z( z
* r8 f- U% z+ E4 ~& T$ O# n- K
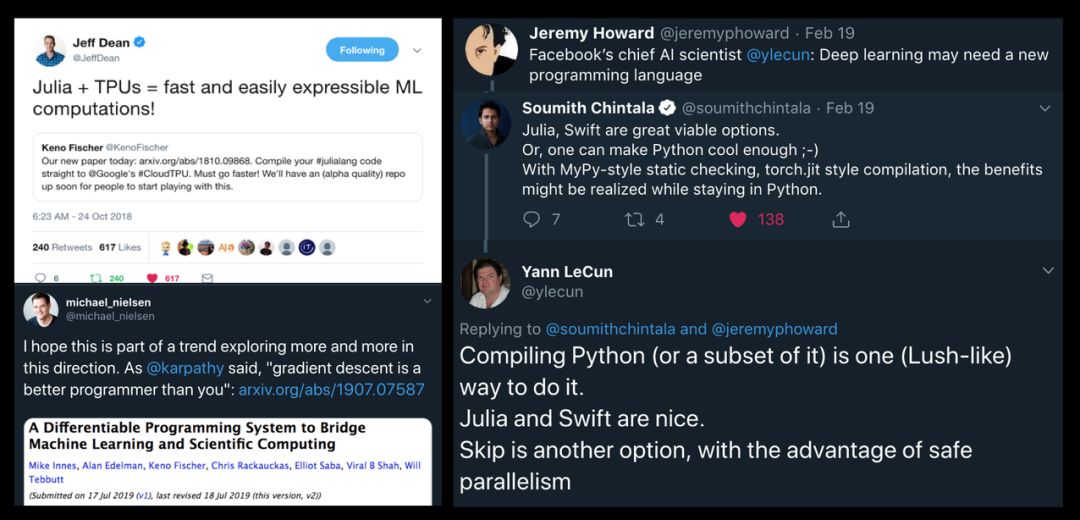
, D5 O6 O# o n7 b# Z# |Julia 在中国已经有非常成熟的社区,它的性能优势也不可忽视。Viral 通过大牛的 Twitter 展示了为什么深度学习需要一种新的编程语言,不论是出于性能上的考虑,还是出于编程模式上的考虑,一种更专注于机器学习的语言都是有必要的。这种语言应该内嵌可微分编程的思想,并提供便捷的模型 API。
1 @$ m- y% l. ?5 q# X/ k( j8 B5 {6 v' \2 M( H. u
% P& a5 r" P1 n4 M [9 B+ M
' Y4 F4 n- [) Y
* D% [- L4 j- D' \( \0 ]" b( d2 v% z! ^+ h( m
Julia 的可微分编程是什么样的$ K6 L1 E, u4 Y- u7 B: X
( B% g' A( x$ a$ o* f- g
6 H7 c8 h# R$ EViral 说:「我们最近也发过相关论文,尝试建立机器学习与科学计算之间的桥梁。这个名为 Zygote 地可微分编程模块将内嵌于 Julia 语言,并作为第一等的特性。可微编程最重要的特性是执行 source-to-source 的转换,自动微分转换基本上没有运行时开销,因此它要比反向传播的实际计算成本低很多。」
7 P, C' p3 m! S$ D- P
: r' e- W' ~ M2 b2 f6 y% h4 |8 k# k) h7 Z9 ]& `6 [( ]
如下所示 Viral 介绍了可微分编程与一般的编程有什么不同。- P* m" _9 i& e) |
3 g2 q+ Z$ ]4 M* @
0 ]* Q! p) P) {. j' j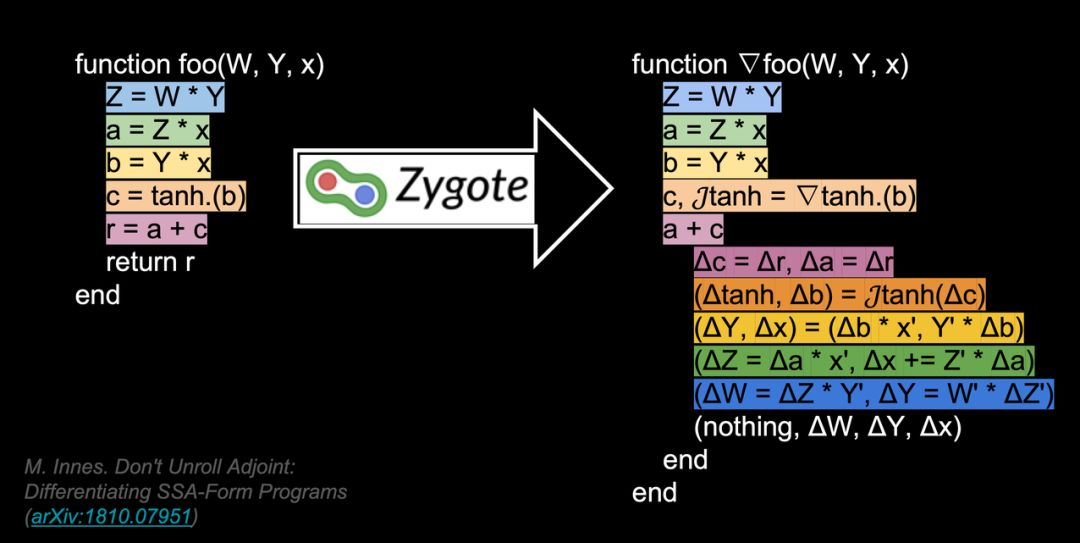 ! A7 L! X+ U% p4 G
2 X1 O4 a5 f! S F+ _0 w" s
) {0 h; _+ f# j2 B; HViral 表示:「Zygote 可以对任何函数进行数值计算与梯度计算,只要我们如平常那样定义了函数或高级函数,那么 Julia 和编译器就能自动算出梯度。这种梯度可以用于进一步的运算,例如反向传播或梯度下降等。」这是 Julia 非常重要的一个特性,它能处理更广泛的任务,例如应用物理学或分子生物学等。( `( s. N: n1 m8 ]/ v3 d/ Y5 {. _
* ^7 u9 z: [: l% `- @ n3 N
2 f' j+ W( p4 Z5 c* Z「不止机器学习,其它广大领域的科学计算也需要利用这种可微分编程的优势。因为它们之间有很多相似的地方,例如都会使用最速下降、拟牛顿法等基于梯度的方法,都依赖线性代数等等。」,Viral 强调到。1 H6 }2 i! c9 j! |2 F- V
, Q. L0 N) V5 e+ z) U
; U1 J; p. W0 I- [6 `5 i3 k
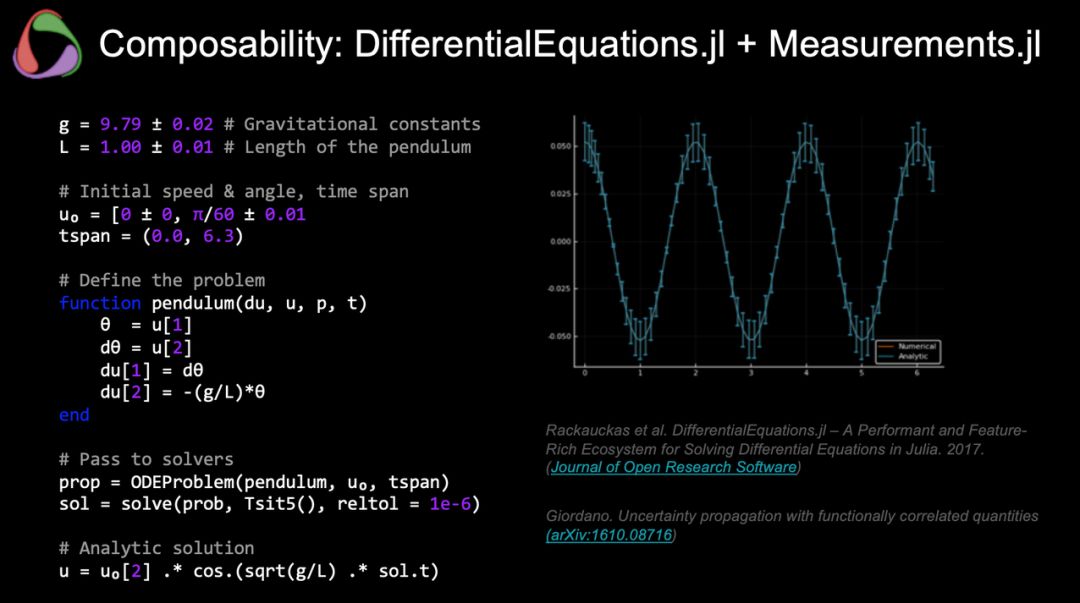
后面 Viral 还介绍了 Julia 与可微分编程的众多案例,如下主要展示了微分方程的应用。- B! O5 p% S) s- j3 P3 r+ O+ V
4 N* U( @- v0 \" R' U! s9 g8 Z* w) Y: D t8 p
c2 T+ I, [2 e- X! P+ t) N5 Q: }& V: K; S8 l
4 ?# j- M' M; B Y* V+ }1 T, p
Skymind Adam Gibson:AI 对第四次工业革命的推动 ) W8 R8 [7 l E1 R
+ v9 U- G8 g% N% {
a5 B- u) A" T% a
自 18 世纪以来,人类社会先后经历了三次工业革命,从手工时代逐步过渡到蒸汽时代、电气时代和信息时代。而今,我们正在经历以基因、人工智能和清洁能源等技术为突破口的第四次工业革命。其中,人工智能是推动第四次工业革命进程的一股重要力量。
: z6 d4 m/ O3 b0 s- b2 w& o
% w# n5 M7 k3 U8 r5 l0 `! G( |1 u' ]% }, `! W5 n* B O0 P, P; m
在本次的开发者日上,美国人工智能/机器学习公司 Skymind 联合创始人兼首席科学家 Adam Gibson 做了主题为《The Driving Force behind theFourth Industrial Revolution:Emerging of AI in Industrial Applications》的演讲。5 I/ F) _' b' ]* y
6 o* \' K$ z- j% s
& b4 G7 U! W) L4 c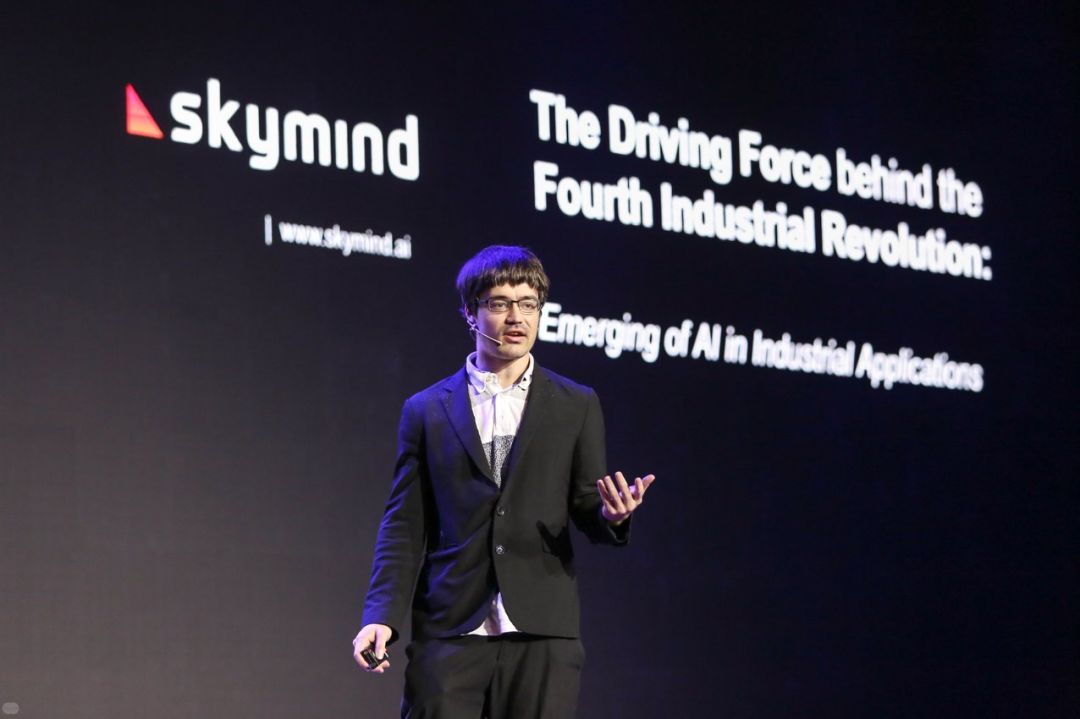 * r R4 |1 F' J' Q1 Y
除了创建 Skymind 之外,Adam Gibson 还是最广泛使用的开源机器学习库 Eclipse Deeplearning4j 的创建者以及旧金山 Galvanize 技术学校数据科学硕士课程的顾问。
. }3 z) o. P" t/ q% i: R6 K( J2 I7 @% r7 I/ [0 t, C, U$ F$ o" t& g, o
/ m! [, l r8 ~+ b0 `3 _Adam Gibson 在演讲中指出,维护、维修、人机合作、生成式设计、供应链、产品优化、网络安全等都是工业 4.0 时代的推动力量。
# `0 j# X) U3 J& O4 e) c* _" _6 ?3 y* P# S$ u6 Y
6 g$ _2 [+ L3 Y) Y- J企业中的 AI 应用现状# A% M5 l( p" U. Z
X4 h7 q8 p) p, {8 T) W' ]9 l+ D% @! Z% q7 q
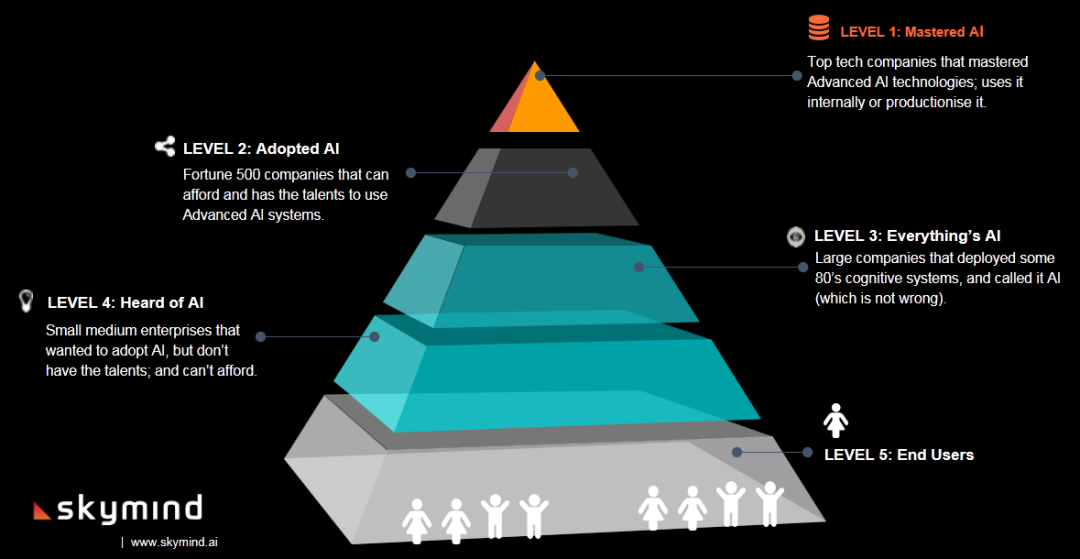
既然工业 4.0 的实现离不开 AI,那么 AI 在企业中的应用现状如何呢?Adam 指出,目前全球通过 AI 获取价值的企业还不到 5%,而且这 5% 的企业对 AI 的利用也大多不够充分。其中有些中小企业只是听说过 AI,但没有人才或资金来帮助实现 AI 的利用,还有些大公司声称自己用到了 AI,其实用的只是上世纪 80 年代的认知系统。只有极少数 500 强公司或顶尖科技公司才能足够的人才、资金利用先进的 AI 系统,并利用其产生价值。1 f0 o' z+ t8 E1 |% c; I! P
; T# d' M; q" V2 |4 `6 Q$ t1 e% l. J7 |. d. g$ W
 % S {- @) q* r4 `9 [8 R# t& S, L
: |5 J8 g. r9 V' [' k( }0 g5 L4 v0 r* D/ z0 b+ c
此外,Adam 还指出,我们现在要做的就是降低 AI 的应用门槛,通过多样化的处理将学术研究成果转化为更加实用的现实应用。同时,我们还需要看到市场需求所在,还很多论文忽略了这一点。6 P6 Y) p# M1 {' z
g9 k' H6 H, D2 @ @ Z, X5 ?0 q5 J t
如何在工业 4.0 中应用 AI?
. B! L. Z% z6 M: L& \
2 o7 v) `( j" Z9 M
1 `/ r. C8 Q7 T5 h0 |6 @除了上述人才、资金等条件外,在工业场景中应用 AI 首先需要解决数据问题,因为这些实时响应的工厂都是新颖而独特的,无法提供训练 AI 模型所需的大量数据。2 A+ b$ E; C3 Q& w* z4 m
: [ A+ v5 R: o4 o" q O; v
" A/ q0 p& _, c9 R2 X7 [对此,Adam Gibson 呈现的解决方案是将模拟与 AI 结合起来,即在模拟器中创建许多 AI 可以学习的可能场景,这也是强化学习模型的训练方式。
- y. e6 R7 R6 Z+ ^/ ~9 D- G9 F5 w: H9 U u
" j+ |6 {; _( d, l+ q
强化学习不止与 Alpha Go 有关,同时也是我们通过模拟来做机器学习的一个分支。
6 p3 d. m% m K* F; s
' Q2 p3 w1 y7 q$ q6 N7 `0 j3 T% A* ]0 [5 ^9 P J& ~5 W. |
广告商如何投放广告才能实现效益最大化?物流公司如何优化送货路线才能降低成本?从供应链、智慧交通、人机协作再到工业流程模拟,工业 4.0 时代的许多问题其实都可以归结为 NP-Hard 问题,即组合优化问题,而强化学习为这些问题提供了一个可行的解决方案。利用强化学习学到的策略可以部署到各种设备中,以自适应的方式自动完成某些任务。0 `+ h) b. T7 z, K
+ |/ T5 Z) _& y# y7 `) d
' I7 G& _, J4 @! K! @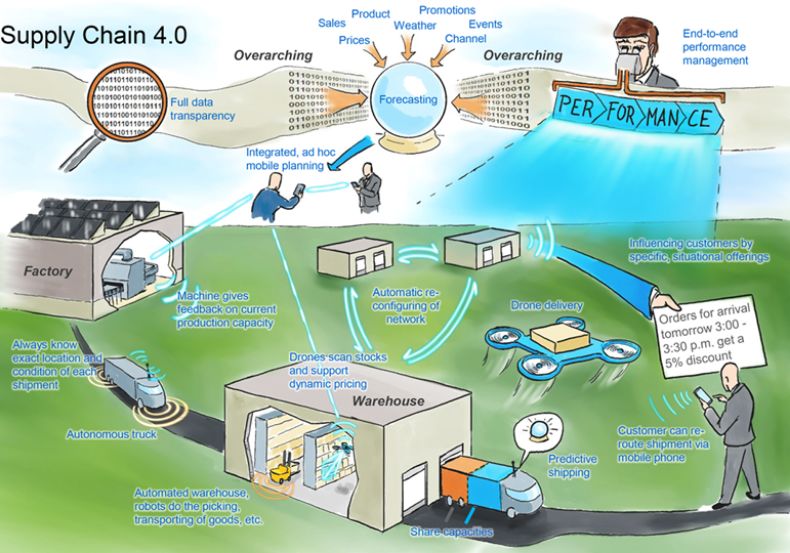
" l8 D$ F8 e- }2 G$ p8 ]+ r- b% Q3 g9 B7 e$ S0 a+ Q5 _8 W# w5 `
2 q2 z# l5 w/ B
此外,Adam 强调,在这些场景中,我们要打造的是一个端到端的解决方案,建造一个中心化的系统,把数据收集到一起,然后不断进行模拟、迭代。$ C( P' Q/ R; e" b- z0 ^) z
- A1 ?9 F. y* R0 H4 g: ^7 e- X8 B
! S3 ^: v1 l/ g; I
以上这些都是主单元的主题演讲的精彩内容。当日的主单元还包括WAIC黑客马拉松颁奖典礼、两个圆桌论坛等精彩环节。
/ ]% a0 c( H R4 P. V/ j' N4 L; J1 H' H/ a
经过一天的高强度知识洗礼,相信大家都回味无穷,很多读者可能也都希望亲自听听大牛口中的「开发经验」都是什么样的。这里机器之心准备了重播链接,点击「阅读原文」观看整场 4 个多小时的知识盛宴。
7 @* \+ A# X/ S
! ^8 o6 m" j: j3 y I K; z) ]7 Q( ?. k% @: i% a
1 p; f6 g' K, V7 l( |: ~
4 _) K$ y$ l _! Z
本文为机器之心报道,转载请联系本公众号获得授权。
+ Z: P, u& F1 V4 X✄------------------------------------------------加入机器之心(全职记者 / 实习生):hr@jiqizhixin.com投稿或寻求报道:content@jiqizhixin.com广告 & 商务合作:bd@jiqizhixin.com; a( i1 Q) i- V+ j
来源:http://mp.weixin.qq.com/s?src=11×tamp=1567326604&ver=1825&signature=e5agdBSSGq8YPKsP8BOGJpnGqq*vhv6ldkToM8IdpYozvvXc2EguqwjYOASEXKBiaECAQzjFhxZHiiHtZ30YFZnvnVHxzKCnZdPaPW15Cr1oNsjkbuc1SZkdZSDRxb6q&new=1
" w* E+ D8 C. _0 w$ H, }$ T免责声明:如果侵犯了您的权益,请联系站长,我们会及时删除侵权内容,谢谢合作! |
 |手机版|小黑屋|梦想之都-俊月星空
( 粤ICP备18056059号 )|网站地图


 发表于 2019-9-1 16:49:57

