|
|
正则表达式之基本概念
! ~& r8 C0 ]: `' o+ ^8 W: E" H; y0 `* P- v0 Y0 P
在我们写页面时,往往需要对表单的数据比如账号、身份证号等进行验证,而最有效的、用的最多的便是使用正则表达式来验证。那什么是正则表达式呢?# s# G4 \$ Y3 l: v9 b' R
正则表达式(Regular Expression)是用于描述一组字符串特征的模式,用来匹配特定的字符串。 它的应用非常广泛,特别是在字符串处理方面。其常见的应用如下:
" E! `* V4 d( Y/ F" C
9 B* N$ {# F* I4 q' [- 验证字符串,即验证给定的字符串或子字符串是否符合指定的特征,例如,验证是否是合法的邮件地址、验证是否是合法的HTTP地址等等。 & d' h5 c# o; r9 X2 {# n T1 V
- 查找字符串,从给定的文本当中查找符合指定特征的字符串,这样比查找固定字符串更加灵活。
) M5 u( O- l- \ - 替换字符串,即查找到符合某特征的字符串之后将之替换。
e; `! F- v, ]% k" |0 f4 P - 提取字符串,即从给定的字符串中提取符合指定特征的子字符串。# p6 \$ y# n! `3 K
第一部分:正则表达式之工具# d" T: {5 q# n
+ b+ k1 B5 w' k: D8 g( i L
正所谓工欲善其事必先利其器! 所以我们需要知道下面几个主要的工具:$ H& l" K3 \) o
http://www.regexpal.com/ 这个网站中,我们可以在线测试正则表达式。, T/ S a; w4 H% p a+ u& b0 D
http://regexr.com/ 这个网站更为推荐,它自身还包括了一个实例使我们直接测试。9 e, {# b6 B: D! V9 ~
第二部分:正则表达式之元字符$ X% B1 u/ r1 e7 A7 o
+ _2 |7 b. l; V" U B
正则表达式中元字符恐怕是我们听得最多的了。元字符(Metacharacter)是一类非常特殊的字符,它能够匹配一个位置或者字符集合中的一个字符。 如.、\w等都是元字符。/ R. X; S7 \7 D! E
刚刚说到,元字符既可以匹配位置,也可以匹配字符,那么我们就可以通过此来将元字符分为匹配位置的元字符和匹配字符的元字符。) ?3 |7 v3 z: N/ }! z% z+ q% l" n! x
A匹配位置的元字符---^、$、\b
. G' W! J; k2 i5 x$ c4 v& l2 I; W0 o; h$ W1 L/ i3 t
即匹配位置的元字符只有^(脱字符号)、$(美元符号)和\b这三个字符。分别匹配行的开始、行的结尾以及单词的开始或结尾。它们匹配的都只是位置。
# k8 m2 I/ X5 |( I7 o+ h0 D1.^匹配行的开始位置3 Y' f. ?: S' Y. V( ?
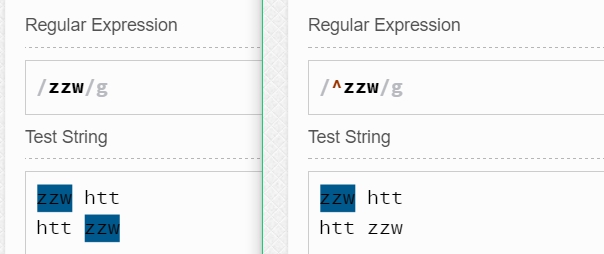
8 A N$ v9 I! P9 t+ K如^zzw匹配的是以"zzw"为行开头的"zzw"(注意:我这里想要表达的是:尽管加了一个^,它匹配的仍是字符串,而不是一整行!),如果zzw不是作为行开头的字符串,则它不会被匹配。! Z- D# ^0 u1 _. H9 ]
2 J( O8 t$ N7 @' H2 q* J; @
2.$匹配行的结尾位置
( M7 V7 K+ g; Z' {
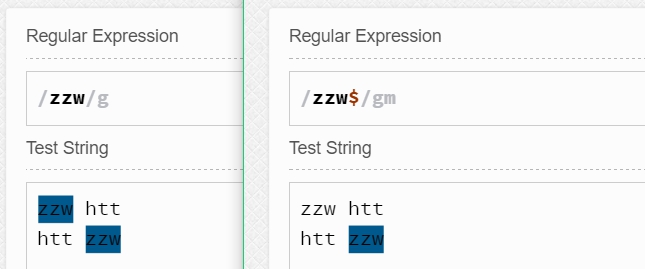
: M8 P- C7 G) l O- h9 X如zzw$匹配的是以"zzw"为行结尾的"zzw"(同样,这里$只是匹配的一个位置,那个位置是零宽度,而不是一整行),如果zzw不是作为行的结尾,那么它不会被匹配。$ L3 s( O1 ?! W) S- h9 K" z
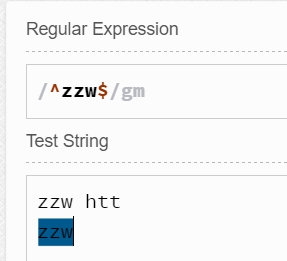
9 r9 I) K8 J+ l于是结合^和$我们就不难猜测^zzw$匹配的是某行中只有zzw这个字符串了。
; X8 T# a" ?8 ^, u* }$ P Z t- o$ N2 f/ ]2 R
而^$匹配的则是一个空行,这个空行中不包含任何字符串。
V; v, d$ r" [7 M2 K( V+ b3. \b匹配单词的开始或结束
& y0 @, j. O% e! S) |9 d, |- N9 q n% m* W2 Y
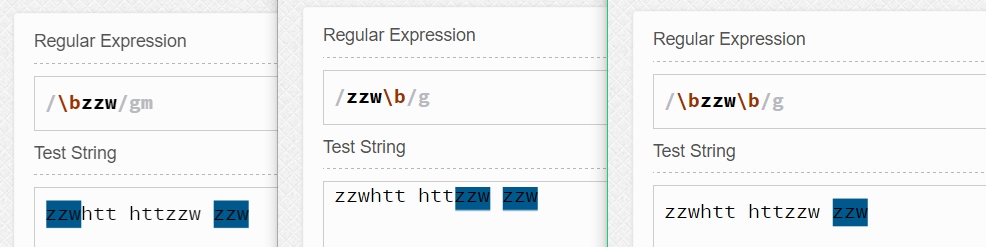
如 \bzzw匹配的是zzw之前是空格符号、标点符号或换行符号的zzw(注意:但\b匹配的仅是一个零宽度的位置,而不会匹配空格、标点符号或换行符号)。& \$ L$ G% z$ t. I
而zzw\b匹配的是zzw之后是空格符号、标点符号或换行符号的zzw(同样,\b匹配的是一个零宽度的位置)。
. p Z6 g- w2 E& s! V3 Z显然 \bzzw\b匹配的就是zzw的前后必须是空格符号、标点符号或换行符号的zzw。
/ X8 d* F! u9 {2 v* y7 O( G
7 w6 K* Z" V0 E( x9 I; |B 匹配字符的元字符---. 、\w、\W、\s、\S、\d、\D
' A5 H7 H. o. k; Z2 I4 S3 p. l! S5 ^ t! ]/ [
即匹配字符的元字符共有七个。6 t+ e$ a0 T1 N; O3 t: S
其中.(点号)表示匹配除换行符之外的任意字符;. W# P0 a. ?' Z! N# s5 e
: ? ^5 |3 F0 U- \w 匹配单词字符(不仅仅是字母,还有下划线、数字和汉字);\W匹配任意的非单词字符(注意,与\w刚好相反); ; P+ W) l7 c E* ]
- \s匹配的是任意的空白字符(如空格、制表符、换行符、中文全角空格等); ( |, K: S% o# E% ^' h5 K2 k, W
- \S匹配的是任意的非空白字符(注意:刚好和\s相反); U9 }1 Z/ D+ X: U1 {& q% x' w, g0 A
- \d匹配任意的数字; : j) Y% v& R* l1 H" ` y' d* H) ?
- \D匹配任意的非数字字符(注意:刚好和\d相反)。, X3 w3 @8 }6 @ K
例子如下所示:
# }7 L' U6 z& ^6 w
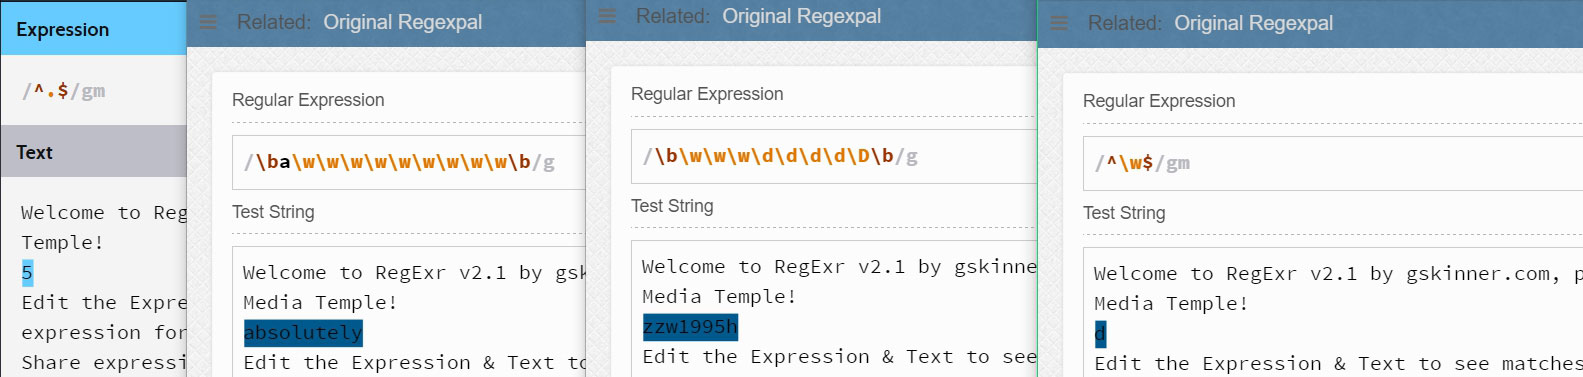
* e& v5 e! H y$ K0 B上面的四个例子从左到右依次表示:. E/ y2 @! f' I: R6 y
% b! e7 p( M% V4 G- ^.$表示匹配一行中的唯一一个任意的非换行符的字符 W. a. g* Y4 e+ a8 p* L2 I
- \ba\w\w\w\w\w\w\w\w\w\b表示匹配以字母a开始的后面有9个字母字符的单词。 (注意:其中的a并不是元字符,就是一个普通的字符,我们称之为字符串字面值(string literal)-所谓字符串字面值,就是字面上看起来是什么就是什么)
. O- |% z+ A, _% ^ - \b\w\w\w\d\d\d\d\D\b表示匹配以3个字母字符开始后面紧跟着四个数字字符且最后一个不是数字字符的单词。
V, @& z2 {! ]7 W n1 v 第三部分:正则表达式之文字匹配
4 r+ E3 P2 Q4 m6 E9 Y/ z* S0 I1 c$ j& n5 Q1 h+ G
这一部分我们将通过字符类、字符转义、反义这几个部分来学习。
$ B9 C j9 f* K/ ^$ C7 V% iA、字符类; O. P4 J& V" _9 l- {
$ r }2 r& ^& _/ x
字符类是正则表达式中的“迷你”语言,可以在[]中定义。5 A! ]5 X% c/ Y* V. |6 @6 L6 Y9 }
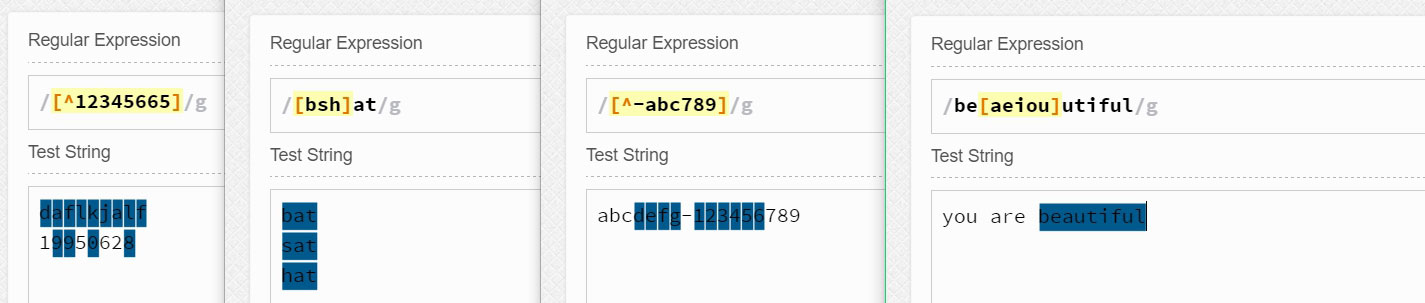
最简单的字符类可以由[]和几个简单的字母组成。比如[aeiou]可以匹配aeiou五个字母中的任意一个。[0123456]可以匹配0123456这七个数字中的任意一个。而可以匹配到HTML标记中的中的任意一个标记。而[bhc]at就会匹配字符串bat、hat、cat。也就是说字符类[]中的多个字符只会匹配其中一个。* _& @1 u+ G3 P. p0 }
但是显然[0123456]、这样的表示太麻烦,需要写的很多,所以我们可以使用 -连字符)来简写之,如[0-6]和。于是可知[0-9]和\d的作用是一样的。[a-z]可以表示所有的小写字母,[A-Z]可以表示所有的大写字母。[a-zA-Z]可以表示所有的大写字母和小写字母。0 t8 _5 k% J, v) w8 b& ?
值得注意的是 -(连字符) 只有在字符类中的中间位置时才是“到”的意思。而[-b]5中-没有在两个字符之间,所以它表示的是-5或者b5。
6 C0 F8 K" ~* c& E除此之外,我们知道^时只匹配行的开头,但是如果^出现在字符类中的第一个位置,那么它表示否定该字符类。如[^123]表示匹配不是数字1或2或3的其他任意字符。[^-]表示匹配不是-的任意字符。
" c3 o7 A: `0 v: d3 L! I" {: T由此我们也可以发现:在字符类中使用元字符(-、^等)时,不需要进行转义运算。9 c- x V) `8 r! _* L
更常用的有[^aeiou]匹配元音之外的字符、[0-9a-zA-Z_]匹配任何数字、字母(大写和小写)和下划线,这等同于\w、[^0-9a-zA-Z_]匹配任何非数字、字母(大写和小写)和下划线,这等同于\W。
, z+ `) ]+ x1 F5 G" D" j9 N$ I) t( J" g
B、字符转义
2 n' j4 h9 {" b, R* n" e4 ] A
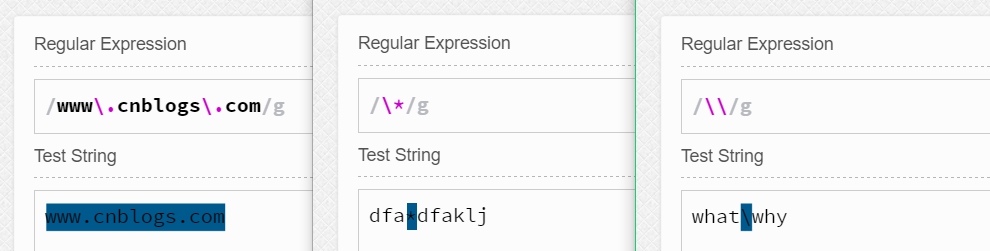
6 @6 l+ s E- Z8 c* W1 G# o我们知道元字符如&、^、.等都表示着特殊的涵义,如果我们希望把他们看作一般的字符去匹配字符串,并且恰好他们又都不在字符类(如[&]中),我们就需要使用\(反斜杠)进行转义了。- }, y5 o' E# H+ p
如我们可以使用www.jb51.net来匹配www.jb51.net。 我们可以用\*来匹配字符串中的*(通配符)。 我们还可以通过\\来匹配\。举例如下所示:
( y0 ~2 g! w! }, D9 W9 Z2 V+ }$ K$ }. `% P' S0 T5 t$ H _! l( Q2 [
C.反义
' \9 z5 b% R4 _9 R
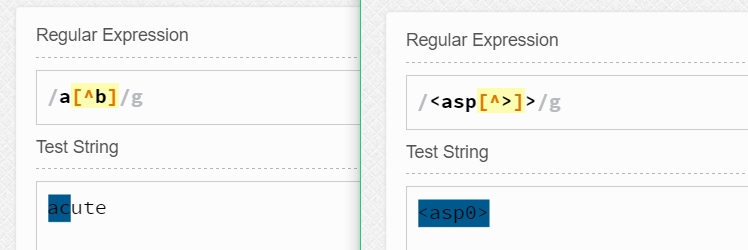
$ O% k/ L% x5 ?8 D; m实际上我们在前面已经说过了,这里再说一遍是因为希望可以引起注意,即^再字符类中的最前面时表示对这个字符类中的字符表示否定。如a[^b]匹配a和a后面不是b的字符。又如]>表示匹配的字符。举例如下:- Z: v, t1 L* \$ p2 l0 F W
1 m3 }/ m" a2 S$ a, X7 U8 R8 b第四部分:正则表达式之限定符
0 {) q! N1 t4 H7 G, ?$ \$ n4 S% z0 G
什么是限定符呢? 我们知道,在前面的例子中,我曾经使用过\ba\w\w\w\w\w\w\w\w\w\b表示匹配以字母a开始的后面有9个字母字符的单词,显然这样写是十分麻烦的,如果我们能把\w这些重复的用简单的形式来写就好了~ 没错,限定符就是干这个的,利用限定符我们可以重新写成\ba\w{9}\b。对,就是这么简单! 下面让我们了解更多吧。
- U: i! o. b0 |% ~# Y ) A, ?3 I1 y' q6 s1 s7 s; ?
- {n} 表示重复n次,如\w{5}表示匹配个单词字符。
/ K2 f0 C. v% d, E/ N+ `$ M - {n,} 表示重复至少n次,如\w{5}表示匹配至少5个单词字符,也可以是6个,7个…… 0 r% E! j/ ]9 E/ y- Q0 U! h4 f" @
- {n,m} 表示重复至少n次,最多m次,如\w{5,10} 表示匹配至少5个,最多10个单词字符。 ; L' T! O! d- h: I6 G
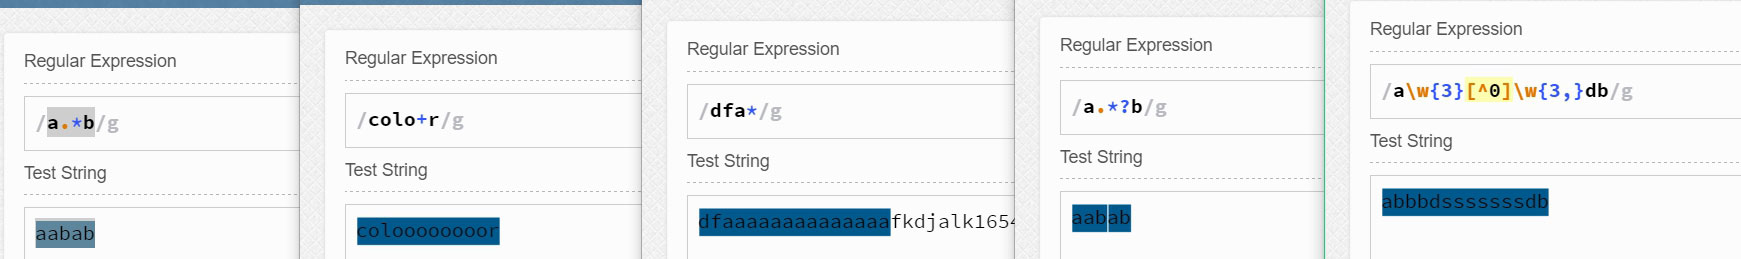
- * 表示重复至少0次。 等同于{0,} ,即hu*t可以匹配ht或hut或huut或huuut……
1 N9 s! n0 a) L" m - + 表示重复至少1次。 等同于{1,},即hu+t可以匹配 hut或huut或huuut…… 6 x% ^- m6 D/ g% P' ^, v8 Z8 F" K
- ? 表示重复0次或1次。等同于{0,1},即colou?r表示匹配color或者是colour。/ J" s! b0 M( v; q2 w
显然,上面的限定符所指的i安定都是限定的前面的某一个字符。$ V1 f+ ?1 b9 J" B% Y. Y$ s
但是,如果我们在上面的限定符之后加上一个?呢 ,这时我们称之为懒惰限定符。 相应地,我们称上面几种匹配为贪婪匹配。- H" G. P) _/ g$ h9 f5 U7 Q
3 r6 |; D3 ?7 L1 D& V: i3 a( G
- {n}? 等同于{n} " y# W$ A% R8 t9 g+ `5 _
- {n,}? 尽可能少的使用重复,但至少使用n次 & ^! T/ m% T$ w. k
- {n,m}? 重复n次到m次之间,但要尽可能少的使用重复。 . p2 u: W* L: g J7 h8 n
- *? 尽可能少的使用重复的第一个匹配
# w/ [! [) E3 [) H& q; k7 b - +? 尽可能少的使用重复,但至少使用1次
! k$ c; Y& b$ P$ X3 O" h - ?? 使用零次重复(如果有可能)或者一次重复
, |8 R" \! B$ W+ L5 R0 p 比如:对于aabab这个要 匹配的字符串而言,使用a.*b会匹配aabab,而如果使用a.*?b就会匹配aab和ab,而不是匹配所有。
" B+ Z7 M7 s4 U U& G
6 F# D% y0 X3 j" M2 E/ |第五部分:正则表达式之字符的运算/ ?. b# j5 z3 U+ ?- L& B; l1 M
6 w9 R) R% F9 L+ H" N
字符的运算包括替换、分组和反向引用,下面我将逐项介绍。
; a2 b3 I. Z9 j3 T, q- @4 m1 j5 |A 替换- X' ~$ F; Y# ~. Z6 t% `
9 {4 ^2 ?5 S) e& d
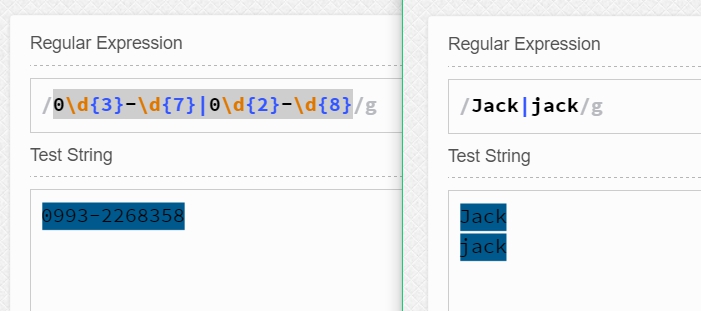
什么是替换呢? 显然就是指一个不行,我用另一个来替换,比如0\d{3}-\d{7}|0\d{2}-\d{8} 就表示匹配前4位为区号、后7位为本地号码的电话号码,亦可匹配前3位为区号、后8位为本地号码的电话号码。| 表示的就是替换了。 又如[Jj]ack和Jack|jack的匹配效果是一样的都是用来匹配Jack或jack的。也就是说,替换|是或运算的关系。
5 ?; I+ Y X$ B+ p在一般的或运算中0 0结果为0, 0 1结果为1, 1 0结果为1, 1 1结果为1。那么在正则表达式中同样是这样,如果一个都匹配不上就不匹配;如果有一个能匹配上就匹配一个;如果两个都能匹配上,就匹配两个。 举例如下所示:4 H7 J; H. P1 o( \4 D- A4 _% V1 n
+ g6 S+ j, s) { V( `: x1 xB.分组8 c) g$ W' a2 C3 @# x
/ v7 C6 y5 `' p+ S1 ^6 v& ]! Z
正则表达式中,分组也是一个非常重要的概念。看似复杂,实际上分组就是使用"("和")",即左圆括号和右圆括号将某些字符括起来看成一个整体来处理。
8 U- m, \1 n }比如我们希望匹配abcabc。如果是abc{3}匹配的就是abccc,这不能达到预期,所以我们可以对abc分组,即(abc){3}就可以匹配到我们想要的字符串了。4 z7 P8 s* d0 p% V) e
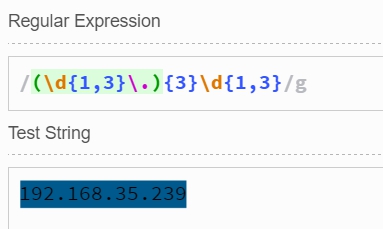
又如(\d{1,3}\.){3}\d{1,3}也用了分组的运算方式,它可以用来匹配简单的IP地址,如下所示:- u+ F/ @4 q3 e* g* k7 x, T
9 S: O# f7 v* K" O) K( `8 R
C 反向引用
b, p0 e8 |- q
* m+ M# W n8 j: }6 ]3 h上面我们通过()可以进行分组,而分组的同时,每一个组被自动赋予了一个组号,该组号可以代表该组的表达式。
6 i! J) n; ], c2 ?; V$ |编组的规则是:从左到右、以分组的左括号"("为标志,第一个分组的组号为1,第二个分组的组号为2,以此类推。# f' P$ [ d9 z0 ?" {7 K3 }# {# t$ b
这时,反向引用就派上用场啦。我们就可以用它来反向引用使用()括起来的字符组了。具体怎么引用呢?规则如下:. e' F R7 l/ x9 U$ U) o
2 _ O2 F, k6 P/ U2 L6 d7 H
- \数字,使用数字命名的反向引用。注:这个是通用的一种方式。
, f- e. C/ G) t - \k,使用指定命名的反向引用。注:这个是.NET Frameword支持的一种方式。& Z# U7 \$ q1 E( n. Q- C7 G
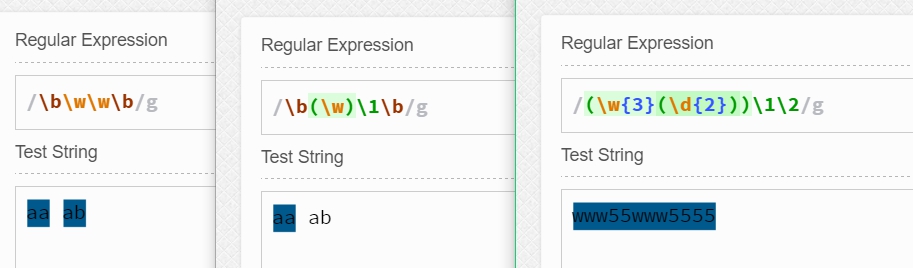
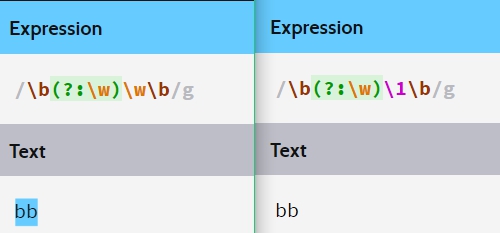
下面的几个例子是使用数字命名的反向引用:
: ~6 A* r: Y( U$ O
# E' ]% ^8 E; t0 J2 ]& u其中我们可以看到第一个和第二个匹配的并不相同---第一个匹配的是两个任意单词字符组成的单词,而第二个由于是使用了反向引用,那么它就必须是两个重复单词字符组成的单词。4 v3 E1 N! o, K! V3 Z
最后一个我使用了两个分组,根据分组规则可知\w{3}\d{2}是第一个分组,\d{2}是第二个分组。 同样注意:反向引用的是同样的字符,如www55www5566,最后两位不同,这就无法正确匹配了。5 N# V5 t$ Q8 J8 q, C+ ~
使用指定命名(也就是自定义命名)的反向引用
- e! F: R: O7 c) h. D# a对于上面的第二个例子,我们用自定义命名的反向引用可以写成\b(?\w)\k\b或者是\b(? 'myName' \w)\k\b。 本想举例试一下,结果都提示错误,可能是上面提到的两个在线网站不支持吧~
# U0 S7 v2 S) E# P, N+ o当然,如果我们希望只是将之看作一个整体,而不希望给其编号,可以使用(?:expression)的方式。如下所示:8 O- K3 F' H1 t" u
X2 Z8 K* P' b m0 `) i- E5 `# |2 ]另外,下面几个也是常用的分组:
4 R* ^% V; V) s! ^) L$ m
5 d/ N2 s) r9 P) h3 Y- (?=expression)匹配字符串expression前面的位置
$ F# P- ?7 u2 C A, v - (?!expression)匹配后面不是字符串expression的位置
1 h9 Q# i$ R9 Y) v+ e" N - (?(?>expression)只匹配字符串expression一次
5 V6 T H+ Z# j, o' v6 T h' N D.零宽度断言
& o: o7 `2 z0 A
; j8 T8 a Y X3 q9 G之前介绍的^和$都是匹配的一个满足一定条件的位置。这里把满足的一个条件成为断言或零宽度断言。& Q1 k1 R1 Z: a- I4 a# H% `
常用的有:
1 K! y: [+ X- f $ e0 X4 L9 f3 A* F- L: V
- ^ 匹配行的开始位置 % X' ?5 X4 ~5 v' P
- $ 匹配行的结束位置 5 S) x& z$ E. Q4 {. p+ X
- \A 匹配必须出现在字符串的开头
( y# n$ |# _' i9 J# L( a5 p - \Z 匹配必须出现在字符串的结尾或字符串结尾处的\换行符好n之前 3 b4 m' c+ o- l5 U1 z6 U! o3 ~/ C7 F
- \z 匹配必须出现在字符串的结尾 ) l4 Q1 J" l7 S9 k; C4 h
- \G 匹配必须出现在上一个匹配结束的地方 8 S U" ]0 |4 i8 Y$ e, w, q7 _' I" C
- \b 匹配字符的开始或结束位置 6 _5 l$ A8 P7 b. O7 K2 x
- \B 匹配不是在字符的开始或结束位置/ D3 B. j% S, G% `' N) _
之前所提到的(?=expression)、(?!expression)、(?其中(?=expression)称为零宽度预测先行断言,它断言自身位置的后面能够匹配表达式expression。如\b\w+(?=ed\b)可以匹配以字符串ed结尾的单词的前面部分,如reseted中的reset。: U& o; e+ r+ D4 ~! l" V
/ W) D0 z: u( R; m! U/ [
其中(? |
本帖子中包含更多资源
您需要 登录 才可以下载或查看,没有账号?立即注册

×
|
 |手机版|小黑屋|梦想之都-俊月星空
( 粤ICP备18056059号 )|网站地图


 发表于 2022-1-8 19:05:38