|
|
|
机器之心报道
( N# K* r, {4 P. N" y参与:杜伟、张倩前几天,OpenAI 发布了 7.74 亿参数量的新一版 GPT-2,并表示将在几个月之内发布 15.58 亿参数量的完整版本。但还没等到完整版官宣,有人就已经等不及了,索性自己动手复制了一个 15 亿参数量的 GPT-2,并将其命名为 OpenGPT-2。项目作者是来自布朗大学的两位硕士研究生,他们复制 GPT-2 的花费大约是 5 万美元。 $ `) c. g3 m7 @: i) Y# t
; E+ Q% a% B) T8 Z) r9 u: I项目的两位作者:Aaron Gokaslan 和 Vanya Cohen 。. V* b' p1 e5 L
读者可以在 Google Colab 上访问该模型并生成文本。; [& Q8 L& Y L/ e f
Google Colab 地址:https://colab.research.google.com/drive/1esbpDOorf7DQJV8GXWON24c-EQrSKOit
& O2 d n/ \: X. A' g5 a0 u$ D% u! H, O, ?, `# W, ^8 M
模型权重:https://drive.google.com/drive/u/0/folders/1KfK5MXtvgH8C615UUZoKPIUVJYIdJxX1
8 J. L1 V' e7 M4 _: w作者表示,复制 GPT-2 没有那么难,论文中的很多结果都是他们两人可以复制的,并且二人并没有语言建模的经验。所以,只要你感兴趣(壕),你也能自己复制一份。) C% o3 }7 F7 B3 V& ~! j! ~
) f- n! R% y6 J& }
$ X, A! y& {/ l$ A7 V# R复制方法和成本6 n" t& U: [! ]0 [' g+ F2 u
8 \" p. d X, {OpenGPT-2 的实现基于 Grover 模型,通过修改它们的代码库来达到 GPT-2 的语言建模训练目标。由于 Grover 模型是在类似的大型语料库上进行训练,所以很多代码和超参数很容易重复使用。他们也没有对 Grover 的超参数进行大量修改。2 `- L: s8 c% ]) J
: @ w5 |1 p: M, ~$ ~8 A
至于成本嘛,他们使用自己的代码从零开始训练 GPT-2 模型大约花费了 5 万美元。但需要注意的是,5 万美元只是云计算的估算成本,没有包含更细微的内在成本(在其他效率更低的易用计算资源上训练模型的效果会更差)。4 I; E1 z. z# L# {
: E+ E# F0 ]' j1 F, P" S& |$ _& i
数据集+ h% M) d- P) z4 {% h
) u- x! e8 @1 O [9 ^/ [OpenAI GPT-2 的原始论文中有对清理数据集的详解。在该论文中,Open AI 的研究人员用到了一个名为 WebText 的数据集,其中包含数百万个网页。5 M* [$ E) }8 }* O
) e$ i, s Q' h( o" l
论文地址:https://d4mucfpksywv.cloudfront.net/better-language-models/language_models_are_unsupervised_multitask_learners.pdf* `* ]# P; ?; s# Y: M2 G( [
6 w8 [4 ~, i2 I
如 WebText 一样,本文中的两位研究者首先解析 Reddit 上 3 个 up-vote 以上的所有链接。同时,他们利用了 Pushshift Reddit scrape 数据集,该数据集集合了持续更新的 Reddit 帖子、评论和有关元数据。然后,作者对这些链接进行过滤,删除那些不太可能包含有用文本或 HTML 的文件类型(即视频文件、PDF 和 CSS 格式文件)的直接链接。$ t, }0 B1 t) Y; |
) A2 K. L/ i, K D2 v7 P
此外,作者还过滤了网页,以删除被各种评估基准和数据集所使用的 Wikipedia 内容。他们并不能确定自己的过滤方法是否符合 OpenAI 的标准。因此,他们使用 Newspaper Python 库从 HTML 网页上提取文本,然后使用 fastText Python 库只过滤掉英文文本。 M$ | { R: F0 n- m! Y2 p
. S4 F! v/ Q m) _# Z
具体来说,作者使用了 WhatTheLang python Wrapper。他们利用局部敏感哈希(locally sensitive hashing,LSH)删除这些文档。最后,他们将这些文档散列到了 5-gram 的集合中,并删除了相似度阈值大于 0.5 的所有文档。
4 ^+ Q t, ^' F+ C2 b/ ]8 X/ \& V% E8 P7 h/ q$ X
作者还从数据集中删除了 token 数少于 128 的文档。这些短文档往往质量较低。作者将这一数据集作为 OpenWebTextCorpus 发布。
6 X- Z, U" W: L0 a* P$ ?
: F: }& y% e8 c8 w数据集链接:https://skylion007.github.io/OpenWebTextCorpus/: O5 s9 o: q8 B8 Z- X v7 K8 x
, ^# K$ [( [& w( G5 D7 h
在编码数据集时,作者使用了 Radford 等人发布的适用于小模型的 Binary Pattern 编码器。他们还利用 OpenWebText 网页爬取代码库的修订版作为自身数据集集合的起始点。/ q& u& A/ t# P# k3 _+ g! |
1 c/ P, f* N$ i& T" R从公开发布的 WebText 的 26 万篇文档的集合来看,作者发现所有文档的双字节编码(BPE)长度最小为 40,最大为 1024。而 OpenWebText 的不同之处在于作者将文档长度的最低值设为 128 个 token(替代 BPE),并且不限制文档最大长度。此外,原始 WebTextCorpus 是在这些样本可用之前发布的,因此作者没有使用这些信息来生成清理启发式。8 x ~- N# W( ]- Q' u5 O( q1 a
1 J e2 k: ~6 Z- ]尽管在训练分布上存在差异,作者依然得出了与多数数据集接近的困惑度。' l4 C; H6 `% q& U
" L* |! Y. D3 g, e
6 F$ d. p7 ~+ J- r9 ^& ~0 }效果* _3 t$ ], u" C% ~5 Z5 i
1 s1 P5 {$ N; N: K0 C' _3 m5 F
两位作者在 medium 博客中展示了 OpenGPT-2 的生成效果。他们提供给模型的提示为:「Recycling is good for the world. NO! YOU COULD NOT BE MORE WRONG!!」,输入模型之后得到了以下输出:- N+ o5 i, K2 [5 @
& b1 `9 M, H: V9 l5 \7 ~/ g/ R. B
4 W P! A0 o9 {5 e8 T2 ~) k, x
8 M# F& u! g7 @: ]8 O
reddit 网友也根据作者给出的连接进行了测试,并将测试结果与 OpenAI 前几天公布的 7.74 亿参数量版本进行了对比。有人表示:
/ \& O. l- H; o6 F! c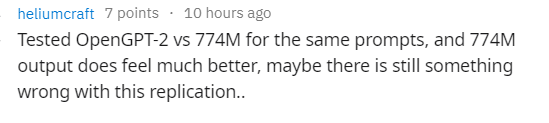 我使用相同的提示分别测试了 OpenGPT-2 和 OpenAI 的 GPT-2 7.74 亿参数版本,结果还是 OpenAI 的输出效果更好,所以作者的复制过程或许存在一些问题。 4 _. H; \5 v* u9 m: t$ V
) r9 P- ~% ^* g* n7 {) y2 ?
当然,也有人认为 OpenGPT-2 的效果更好: v$ O% r7 e7 @5 J: u0 o
6 C, j2 x' D- v8 ~" C) S$ m% Z) ?, W6 i8 i
我认为作者的 OpenGPT-2 效果优于 OpenAI 的 GPT-2 7.74 亿参数版本,但还不足以用来制造令人信服的假新闻。几次尝试输入「Shocking revelation! Vladimir Putin and Donald Trump are」,我得出了以下效果最佳的文本。该文本能够更长时间地保持语义连贯性,语句也更有意义,但还是比较容易被识破。但不可否认,OpenGPT-2 对研究确实很有帮助。; r* _6 l- r+ e) [: K
7 L7 o3 S2 o5 c( f! r/ E5 G+ j
但我还有一个疑问,OpenGPT-2 到底只是把它读过的文本随机组合到一起,还是真正地创造出了新文本。
+ K, C5 F( z0 {$ }; g
9 B3 _* @3 Y& q9 M8 R$ U: _( E/ A1 h, R3 c# b7 u( O7 M: p
. J2 F/ h" K. l至于 OpenGPT-2 的生成效果究竟如何,大家可以根据文中提供的链接测试一下。' M# |7 \& d- K0 ^
# P$ i' n! Y- ~' d1 S7 `参考链接:
) Z: b* {6 Y" Q. ^7 n3 d! E) q4 T7 M7 ?& o- D
& N- ?% n$ W( |: y. j
1 f- U& I# E" Y0 ^+ z5 Q5 t) chttps://www.reddit.com/r/MachineLearning/comments/cu9xgi/p_opengpt2_we_replicated_gpt2_because_you_can_too/
# K' D# ]& q* b2 S4 H; |https://medium.com/@vanya_cohen/opengpt-2-we-replicated-gpt-2-because-you-can-too-45e34e6d36dc8 H( c+ e% x1 w
: H' v% y% l, p9 q: H7 S
: t I/ m0 ]0 E, K
4 d# p( g3 a- G+ Y/ f$ y' I. MWAIC 2019 开发者日 将于 8 月 31 日在上海世博中心举办,包含 1 个主单元、4 个分单元、黑客马拉松比赛和开发者诊所互动区。
. E/ O' C! F) t+ }+ O! c
届时,全球顶尖 AI 专家、技术大牛、知名企业代表以及数千名开发者将齐聚上海,围绕人工智能前沿理论技术和开发实践进行分享与解读。 ; V' d3 p; E& m* l3 B. s
点击阅读原文,立即报名。
; z& p2 q2 }: R. x) [! |6 i- E3 ]9 c z
' i- J0 |0 Z% E) }4 f
来源:http://mp.weixin.qq.com/s?src=11×tamp=1566630003&ver=1809&signature=lixpkgck3Jci-PJs9nuYQ2-e-AoYyRsK9T2JfY8UTHbrfqeLiSdjvkGmvntU-OVvGe8*llf7XPaBdBKSdmrL7CrALKS1LX-KQs*HOTH8twOu5W3TN*s6mdYxiqgYsckc&new=12 d0 W: S( L; t) a9 \& c, r
免责声明:如果侵犯了您的权益,请联系站长,我们会及时删除侵权内容,谢谢合作! |
本帖子中包含更多资源
您需要 登录 才可以下载或查看,没有账号?立即注册

×
|
 |手机版|小黑屋|梦想之都-俊月星空
( 粤ICP备18056059号 )|网站地图


 发表于 2019-8-24 15:03:59
