|
机器之心报道
6 @3 ?9 l) v! w- m机器之心编辑部「DeepNumPy 可以写深度模型,且与经典 NumPy 100% 兼容」,AWS 副总裁 Smola 说,「深度图学习本领强大,Transformer 也可以分解为图」。「Julia 内建可微分编程,定义任何函数,他就会自动算出值以及梯度!」,Julia 创始人 Viral 说。这就是 WAIC 开发者日,属于开发者的节日。
& H' I+ c, ]5 r. [% g% K
9 f" L6 U" m' `3 ~) _- x
/ W/ o; p8 o- U9 ^2 \WAIC 世界人工智能大会已于近日在上海开幕。在昨天由机器之心承办的开发者日主单元上,阿里技术副总裁贾扬清、亚马逊机器学习副总裁 Alex Smola、百度 AI 技术平台体系执行总监吴甜、Julia 创始人 Viral、Skymind 联合创始人 Adam Gibson 做了精彩演讲。/ _" `# r9 J% R5 s% C2 f6 p2 @ P
2 d2 B% T7 u9 B8 n) N: c. \2 z; k$ H) H6 j5 ~* {
阿里贾扬清:从 20 瓦到 20 兆瓦的大脑
' A/ h8 Z" P' @6 c) M& } / F3 z1 y- @! @. [! |
' }2 {/ Z) a: }6 m a, S$ e% F; S2 H4 r2 ?- @/ F$ o
从 20 瓦的人脑到 20 兆瓦的云智能,近年来,随着算力、算法、数据的蓬勃发展,机器学习的基础设施也完善了起来。在 WAIC 开发者日中,贾扬清第一个分享了他这几年在人工智能领域的一些探索和想法。
5 o! @" @* f: W, ?$ P7 N6 x$ o1 {5 T
$ M* R' s! w) z- H) Q8 {" L
1 h Y( ?% s- w% |8 F' m
* [" W/ o# m5 \: C1 _$ H6 Y1 d& S! _; J6 }
贾扬清是知名的人工智能青年学者,在加入阿里巴巴之前,他曾任 Facebook AI 架构部门总监,负责前沿 AI 平台的开发。在深度学习研究、工程、框架等诸多方面,贾扬清有众多为人所熟知的工作。今年 3 月,贾扬清正式宣布加入阿里巴巴,担任技术副总裁岗位,领导大数据计算平台的研发工作。
$ m, s6 H& }$ y) w2 w+ [" u9 @
" _1 X' D# f; @- C9 w6 o9 d0 O4 R, T, ]- |8 S
在第一场分享中,贾扬清以《20 瓦,64 千瓦和 20 兆瓦的大脑》为题,从算法的潜力提升、算力的重要地位、数据的爆发式增长三方面讨论了这些年的 AI 发展,并最终表示「结合三者,云是 AI 的必然形式」。
- u# H# X8 ?& I0 z a2 }, Q
! [# M8 B, @; w# K
* x; h% V- u( q/ f$ D( t" r什么是算法的潜力0 L4 z2 X, p$ V% j
( s9 h. F% ^2 P5 a6 X
' t2 Z3 O' ] O; A8 Y人类大脑功率大约 20W,那么都能做些什么呢?这包括与环境交互、学习、推理等等。但是人工智能模拟起来却非常难,贾扬清最开始从经典机器学习算法讲到当前主流的算法,回顾了这些年算法潜力的变迁。举个简单的例子,机器学习需要图像特征,那么最开始是通过 HOG 获取简单的特征,后来发现「边缘」可能非常重要,因此各种卷积神经网络也就大显身手了。, i- {! ^8 Q# d$ C: m! I5 V
, \- V* f% O) G* v2 t0 ^ h
$ @4 Y& {, N' ^. w- F& G, }% F深度神经网络大大提升了算法的潜力,贾扬清举了个案例,在 ImageNet 图像识别挑战赛中,最开始 SVM 等经典算法已经到头了,但那时它们的潜力也只能支持达到 25% 的错误率。但随着 AlexNet 的提出,错误率瞬间就降到了 15%,而且重要的是,这种方法有很大的潜力,之后的研究使 ImageNet 的错误率一直在降低,甚至低于「人类」识别错误率 5%。0 C, z$ T; ^2 [# t! U
5 p% S/ ?# S; D/ S% U+ L( G
^" W @2 z7 L2 g, h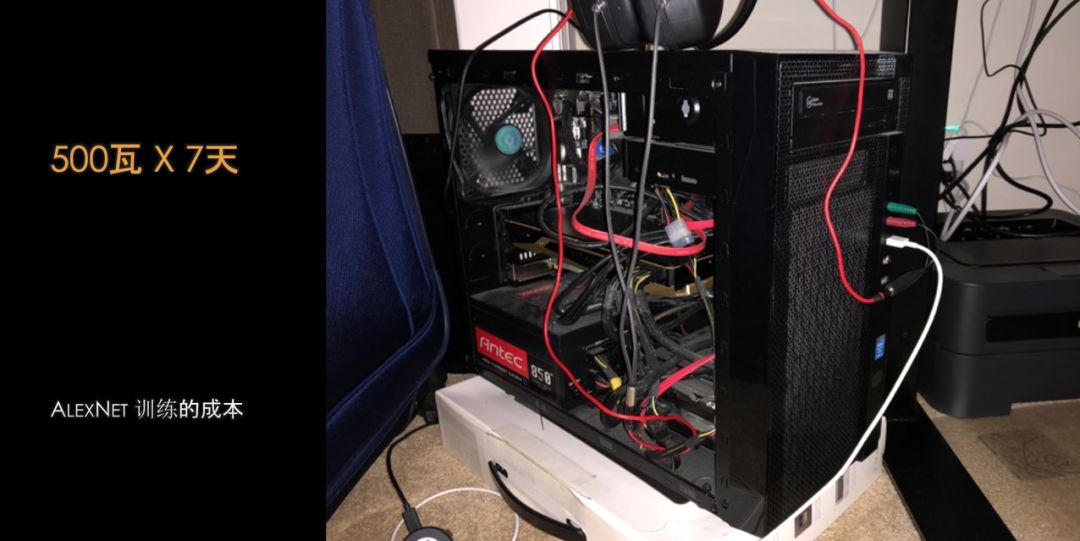
2 ^, p% ~7 C# u5 E1 z+ @
0 N T3 Y, x1 M5 j
" v4 E7 q4 x0 t5 j3 O0 N. Y深度学习利用强大的拟合能力大大扩展了算法潜力,现在算法问题已经解决了,那么算力问题呢,我们该怎样利用计算系统提升训练速度?2 m8 _$ B* f: Y4 h1 L; n) L1 q
1 O c7 }% k* L+ a+ A
% C! `0 r8 d0 H- J# ?; j: P为什么需要算力、数据" j* c+ n, N* _% i* n! M- O
3 H( L a( G# m4 [( E; L( K3 {/ T; q6 h$ ?% }' L" d
人脑的计算速度是有限的,但计算机可以通过堆算力来提高计算机系统或机器学习系统的能力。在这方面,人们一直在研究如何通过系统的方法提高训练速度。
( |( ]2 [1 h- X* I
# S& p+ c( k, {0 V1 |& t8 u) o3 W2 c4 T" T7 |* T
2014 年,机器识别一张图片里的内容要花 13 微秒左右,但今天,这一速度已提升了上百倍甚至上千倍。这一提升得益于 GPU 的聚合:单个 GPU 每秒只能处理 230 张图像,比人快不了多少,但 256 个 GPU 聚合在一起却可以处理 6 万张图像。因此,我们可以通过大量堆算力的方式来提高训练速度,这也是大家前几年不断努力做的一件事情。而这些 GPU 又通过分布式训练的方式进行合作。! H$ g3 c2 `$ i. W8 P# C
! M' N- B5 F. y0 w6 W
, [1 ]. r7 a/ t4 B% ~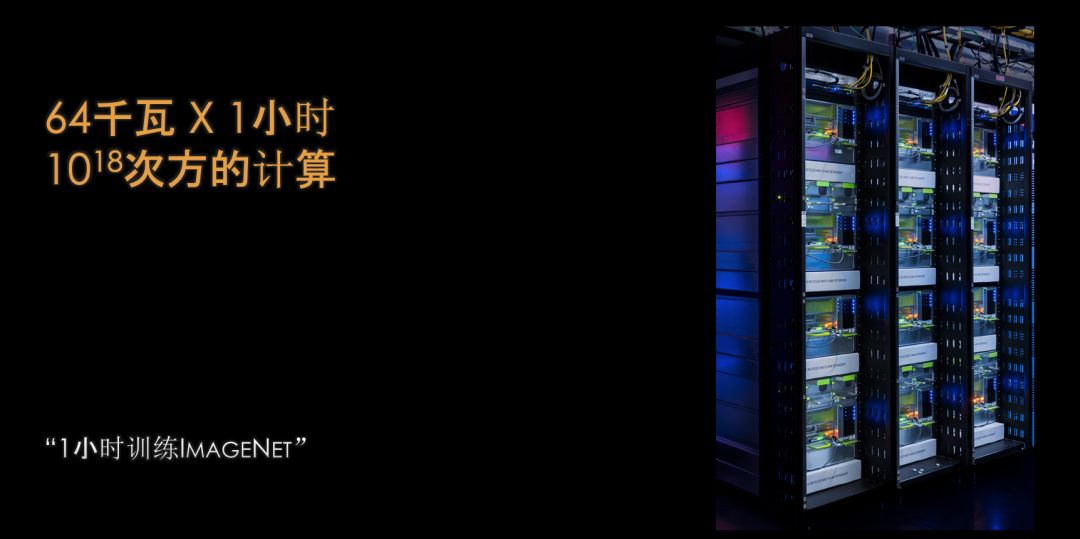
6 v0 G( F9 o2 f$ [8 Y! v$ S8 y6 M- f1 C$ K
8 Y0 f8 S) O. j, |% C6 v K5 D
如果说算法是潜在的能力,那么算力就是发挥潜力的保证。但是,算力将训练速度提升之后,模型的复杂度也随之提高。而模型越复杂,过拟合的可能性也就越大,因此我们还需要更多的数据来缓解过拟合。+ u! j) ~! C) N( F: Z) f8 x' Y( l" T
/ ]$ j# t4 X0 ?( O& A6 V: r9 p A+ G; g
从 1989 年至今,训练模型所需的数据量也经历了爆炸式增长,从 MB 到 GB,再到 TB 和 PB。
4 d9 z p2 p! c4 Y% z, k" h6 t G
3 r- W% O( j) [# i0 `; i. U1 U
: N1 a8 T6 R7 J9 u' L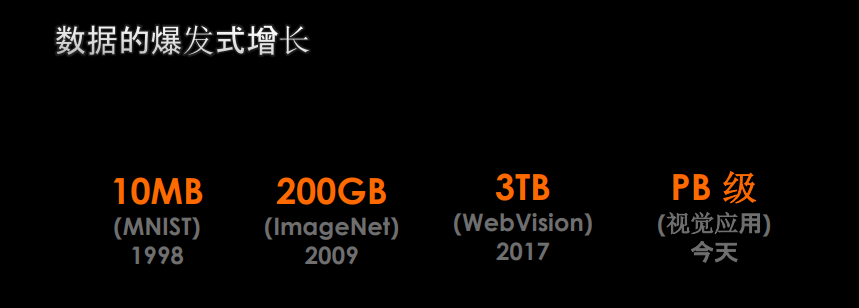
2 P' {* \2 F7 a2 }4 N" z3 f- z# P
9 {4 d- P7 H% L; F! o! [: o: F
20 兆瓦的大脑# s3 a6 Q. V' j
; _. ~8 ?# U; h$ [6 M2 p" s+ J j' ]" }
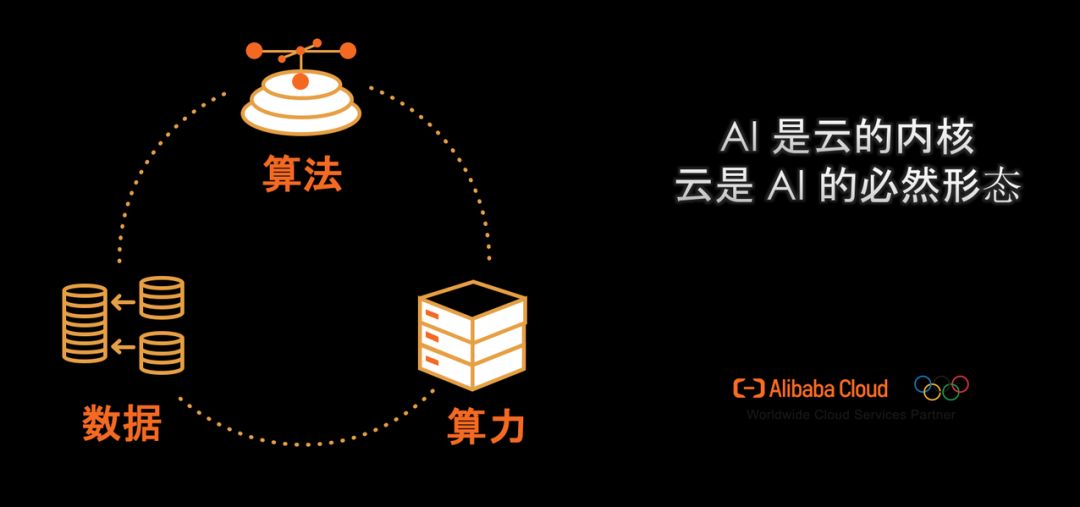
有了高效的算法、海量的数据和庞大的算力,那么怎样才能将它们聚合在一起并应用到实际业务中呢?贾扬清表示,很多科技巨头都是通过云的方式来解决,也就是通过 20 兆瓦的大脑解决。
) ^1 S! A Y6 R- ~( u; T& e/ L5 D2 l7 {4 T; ?
6 j8 B; I; @8 z" N. `* [6 a0 }, v贾扬清说:「为什么我们说只有通过云这种模式,才能够实现机器学习的创新?是因为云向我们提供了更大的规模、更高的可用性、更强大的安全性。」
' I, r) k4 U: ]; s/ {+ D
0 J( F3 p* p& c2 \' R8 y6 m) L, s: w% c" Y, g ]5 u1 K2 m$ Z9 k9 K$ i
) d7 F+ z0 R& w
2 X# x& i+ j& Z0 E7 ]
$ w5 d7 f% v3 s6 ~4 T此外对于公司来说,我们关注的应该是业务,而不是基础架构这些东西,所以云能很好地解决这些问题。贾扬清说:「从 20 瓦的大脑到 20 兆瓦的大脑,我非常高兴的是我们一直在解决各种问题,希望联合算力、算法和数据,从而不断趋近于真正的智能。」
$ E) L! \! ]! b8 K; r
- @! y* k0 I _; L: @$ \
2 H) F' C. i6 K( g; t& |- Z# [% R「AI 与云的结合是一条必经之路」,贾扬清总结道,「我从一个研究者开始逐渐转向了工程、转向了业务、转向了更宽的思考范围,从而将 AI 向前推动地更远,这是我非常兴奋的一点。」
% y" e/ U9 W3 _+ U& I/ z
8 d( r1 x) N/ Y0 |& R' W* a* F8 n7 C, J/ h* B5 A2 w
亚马逊 Alex Smola:深度 NumPy 与深度图学习 3 ~ x4 ^3 Z3 S( @, }4 G' L. \9 Q
) w9 } U6 q5 b2 M9 A2 {9 J+ z, u
NumPy 差不多是所有机器学习开发者必须了解的库,它为 Python 附上了数值计算的「灵魂」。然而随着深度学习框架的流行,NumPy 似乎已经不再闪耀。那么我们是不是能为 NumPy 插上「Deep」的翅膀,用 NumPy 的 API 直接构建并训练深度模型?这就是 Alex Smola 为我们介绍的 DeepNumPy。
: l( A+ n/ l6 r, U
! }7 i& U$ k* n" U
# D1 P2 Z8 l9 @+ T* U
& s# S9 Q$ x- Y, B6 |2 U5 K$ Y2 G' \/ J( c
# {+ M# M5 k' h! [) d/ S6 Q除此之外,Alex Smola 在开发者日上还重点介绍了图神经网络框架 DGL,它与 DeepNumPy 共同为开发者提供最好用的工具与 API。) u$ A, p3 ?) H5 t* A# Z' S% d
% p9 R( ? T9 i% h9 N& a
* a9 s& k1 G( n% f# Q% DAlex Smola 于 2016 年 8 月加入 AWS,现在是 AWS 副总裁和杰出科学家。Smola 被公认为世界顶级机器学习专家之一,他在 2013 年加入 CMU,并担任教授。Alex 是学术研究界的一位多产且被广泛引用的作者,撰写或贡献了近 500 篇论文,引用量达 75000 多次。
1 _' l) t# ~7 t9 U+ k. `
' I1 _6 U! Y; g/ @, B- d) u' D# j* I+ W) ?+ ]9 Q% F
下面,让我们看看 Smola 大神在 WAIC 开发者日上介绍的《Deep NumPy and DGL》都有什么吧。
$ W9 l( `- O2 [. }4 h. D4 Q" @0 Q& m7 \% w( R1 n
0 _* [( m" }9 C0 t
DeepNumPy- e# E) t$ P, j7 Z" K0 f0 a
" i$ m4 z3 B6 }: E5 G9 l" _
]! J* n4 @' G& @. X O* ~Smola 先让我们思考思考,到底机器学习的开发流程是什么样的?这时候我们就会发现 NumPy 即使在深度学习时代,也有非常多的应用。我们习惯了在预处理时使用 NumPy,在预测和可视化时使用 NumPy,甚至在不同模块间传递张量也用 NumPy。除了核心的模型搭建与训练,似乎其它流程都能用 NumPy。
2 j/ f5 ^; H) u9 Y6 \& K$ `: p0 z1 L9 T8 r T* ]( }& u: r- ~( X
' ]; P- k+ P5 h' L- V; o! {# o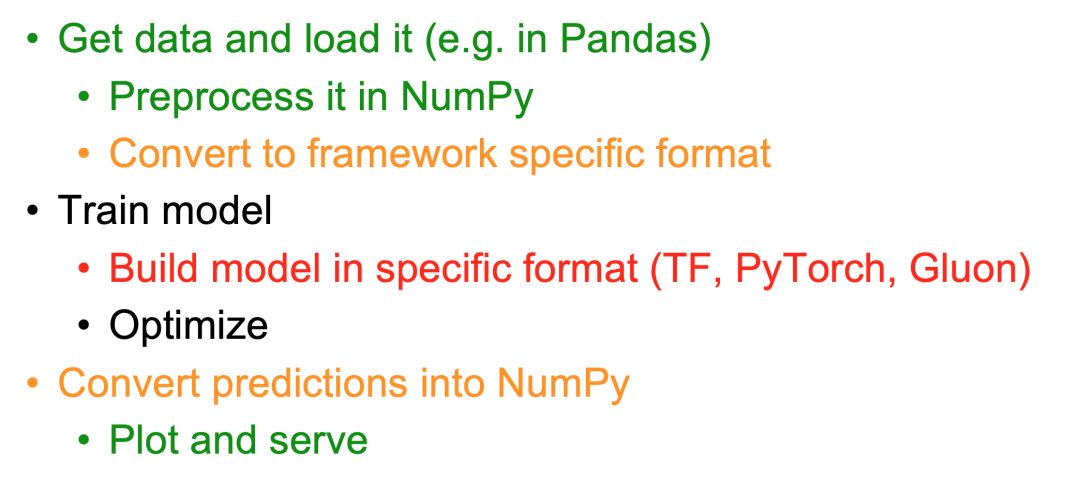
/ {6 m- V- E3 C3 B
' e9 d' R% o' J% u8 y& u; [' A( i: T5 y2 j
那么 NumPy 既然在矩阵运算、数据处理等需要 CPU 的环境下如此强大,我们为什么不直接将它迁移到 GPU,并赋予神经网络 API、自动微分等能力,这样不更方便么?Smola 表示,MXNet 社区正在做这样的事,希望构建和 NumPy 100% 兼容且还能搭建神经网络的工具。* ^: m3 ~, j' Y
1 x' w v" l: \+ T, n) u
# c# y) ~5 J* x/ ?6 W% }
* {. e$ f% k& ~' {- J' c" T
% Z+ B! Y' q }3 V) W简单而言,DeepNumPy 作为 MXNet 的前端,它提供了类似 NumPy 的接口,且包含了一系列用于扩展深度学习能力的模块。DeepNumPy 主要包含两大部分,即 mxnet.np 和 mxnet.npx,其中第一部分用起来和 NumPy 是一样的,第二部分会提供更多扩展运算符,对深度学习更有优势。
( s) W- H1 V. S/ p7 V3 ~2 ?. ?
& M9 I; v8 A/ t
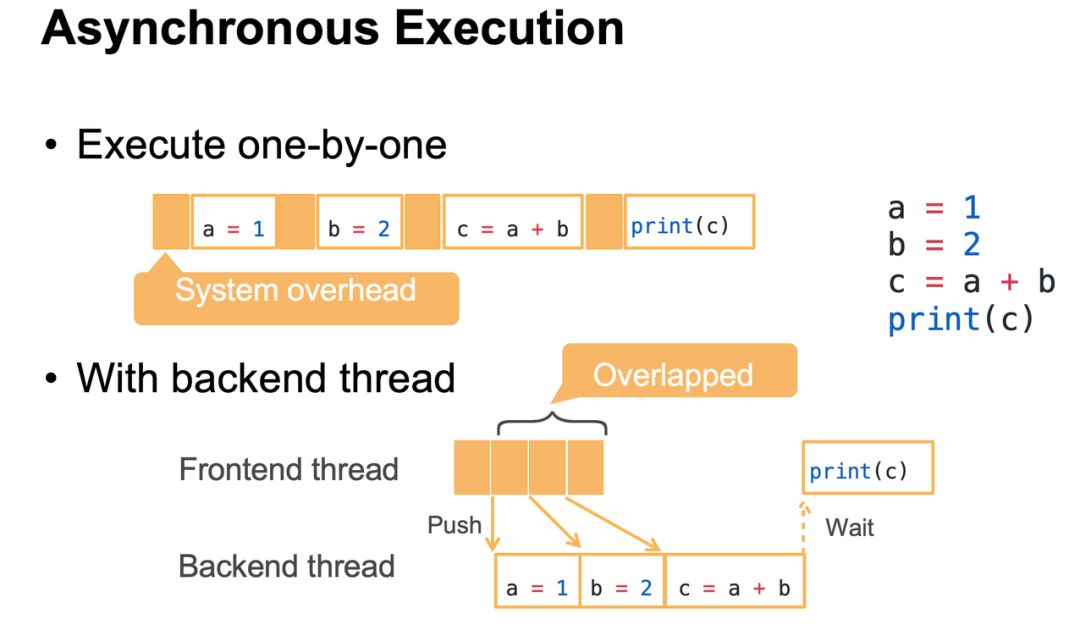
( O: a0 Q3 [, @% t- r. B% d) x如下 Smola 在开发者日中主要介绍了 DeepNumPy 的两大特点,即异步执行与自动并行化。异步执行的优势与过程如下图所示:# y: K7 G3 ], b5 P# G% A% B
- { H7 [3 d7 P' E# n- K0 X0 R% E! y) d" s ]
 $ J0 u7 ?: h2 \# j7 R' q$ C9 Z7 l
: e' E% `, @8 n* b, U1 o
& s( k. m# U: x e- N% [# W) l
一般而言,我们写的语句是一行行执行的,且系统的成本也会和真实运行加在一起。DeepNumPy 的优势在于,后端会以异步的形式处理前端运算。
8 R- w9 u& M m. C7 y6 i
& H7 f1 v$ M6 |' K) M0 K& |: c# ~: R6 E- H* f7 G4 i5 j: l
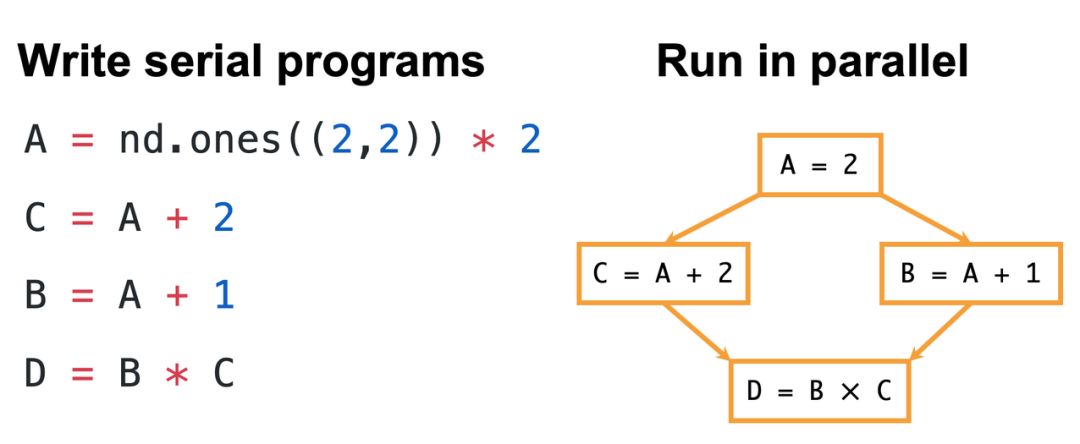
Smola 表示 DeepNumPy 另一个优势是自动并行化,它可以自动解析不同变量之间的依赖性关系,然后优化运行路径。如以下例子所示,即使我们写的是一行行代码,但 DeepNumPy 可以将 B 和 C 两个不相关的变量并行处理,从而大大降低了运行时间。 T f i5 W1 ^7 w
h0 z8 P* E7 A* _. x8 t. S
* M; ~/ v* n" Z4 v. }
8 f/ F7 V [4 Q6 G+ G% p$ B
9 N3 `/ {0 E3 W
9 Q6 ^# r( L. J- q; wSmola 总结道,DeepNumPy 在 Apache 开源组织的管理下,将继续修改各种 Bug、提供更多强大的新特性。目前 DeepNumPy 已经在通过 TVM 优化 Operator,以提供更多的便利,包括支持 CPU、GPU 和 ASIC 等其它硬件。此外在性能上,DeepNumPy 经过 OP 融合与定制化的调度机制,它即使在大模型上也能展现出非常优异的性能。' A6 b* e: c6 |5 g* C, Y
" D# ^# u, b Y" d" M4 q
9 s1 m: ]! H& `# n在听过 Smola 的介绍后,机器之心也查看了这一前沿的开源工作,虽然目前 API 文档还没有完善,但从一些案例中,我们发现它的使用方法真的和 NumPy 一模一样,不论是创建数组,还是执行索引、运算等常规操作,都有一股熟悉的味道。( E e% m; s! O* G
& G% G1 M" T& T) o( i5 y1 {1 ]. T# T/ D
Deep Graph Library$ y0 i0 x9 |. Z( T+ k
7 V2 B/ {6 A2 q- @" G3 X2 m _5 f# t' C9 S) L3 m( Y' G1 e/ W d
Somola 另外重点介绍的就是深度图学习了,这也是近来非常受关注的研究方向。机器之心之前曾介绍过 AWS 开源的 DGL 库,那么现在让我们看看 Smola 眼中的深度图学习是什么样的。
- A$ ^5 I* u( X1 R7 h6 W
8 o+ D J6 E6 U4 h# V
3 O6 U3 Y4 |7 k' A; C" J首先 Smola 先定义了什么是图(Graph),以及它的一些应用,例如社交的推荐和欺诈检测等。图之所以这么重要,很大程度上在于它的表达能力,现实世界上很多数据都能用图来表示,差不多是最重要也是最通用的表示方法。然而深度神经网络擅长的是图像等非结构化数据,它基本上处理不了关系型数据,这就要求「图」算法有更新的发展。
9 A" w* N& n: ~6 A. @
* n G4 C7 o z3 k+ i# u
6 f0 _& Y0 v( b8 @% T/ Q # l m6 E) J9 e! Z; J9 }2 ?4 z
: g' O) u1 F0 P# w
8 r) c0 y0 \1 E' {Smola 说:「DGL 是一个 Python 包,它为现存的张量数据库和图数据提供一个高效的接口。」为了完成这个目标,DGL 必须能兼容多个深度学习框架、必须提供最精简的 API,同时还要高效地并行图的计算。据 Smola 介绍,目前 DGL 已经支持图卷积网络和 TreeLSTM 等多种网络,也适用于很多应用场景。. F" L( M4 H i8 X4 O& l2 h+ z
) y; A6 `# U* i' C
" A) F4 R7 y' F$ iSmola 举了个 Pagerank 的案例,它最开始是一种对网页重要性进行排序的算法。Pagerank 本质上是一种以网页之间的超链接个数和质量作为主要因素的排序算法,因此,我们也可以将网页视为节点,超链接视为连接的边,这样就能构建一个标准的图。7 K8 M0 j# X( z. L' N! I K
6 X9 R" H" I0 K
/ B' Q; m# U1 L5 M7 L- A# i如下所示为 DGL 实现 Pagerank 的代码,它的构建过程非常简洁。1 y, o$ `, ]# l9 V
) c5 s" ~+ y) ~# l4 j
( o6 l0 _% }: o. S2 \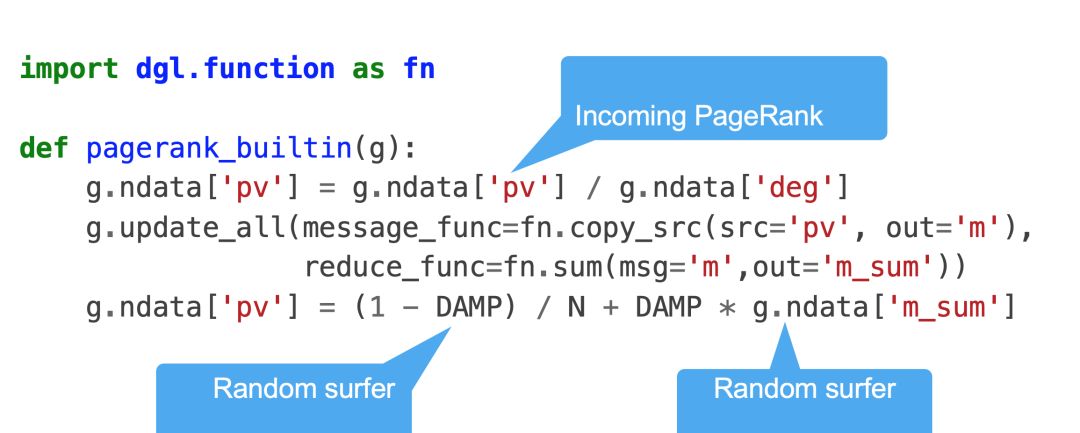 - j; a0 g+ X+ S
% Z7 o$ m9 `& `- a8 O6 f! J, }
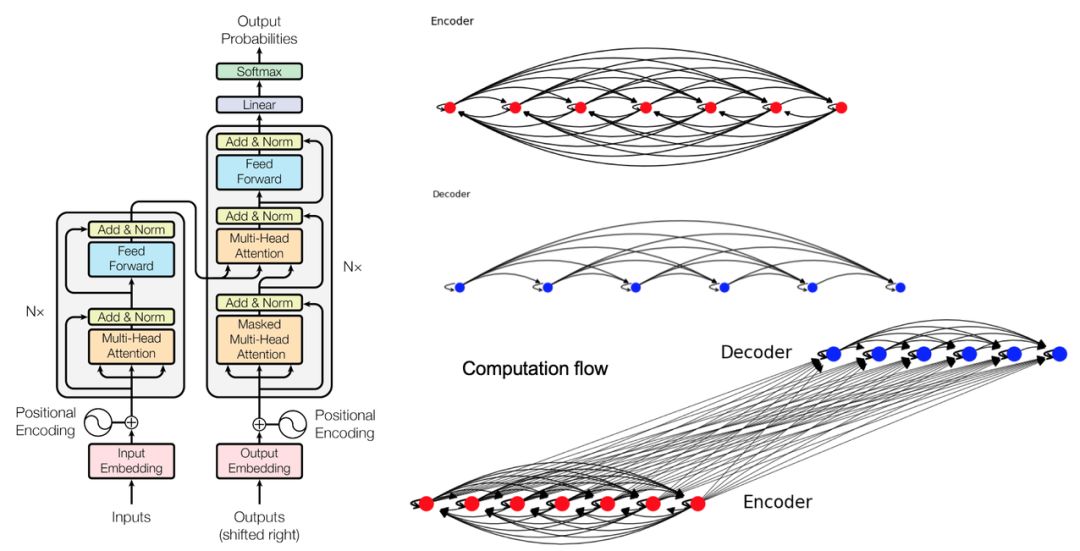
Smola 在现场还展示了更多用 DGL 建模复杂网络的案例,包括图卷积网络和 Tree-LSTM 等,其中非常有意思的是 Transformer,DGL 也可以将它分解为图,从而扩展它的能力。
3 y! w" {7 P2 o' y1 R4 F
" v u9 w4 c/ B' s8 h! z4 U* h9 u: x4 |: W
下图展示了 Transformer 如何解构为图,Smola 说:「我们可以将注意力视为图中的边,并采用边上的消息传递机制作为对应的运算过程,这样我们就可以将整个 Transformer 表示为图。具体而言,Transformer 可以由几个子图组成,其中 Encoder 建模的是原语言图,每一个 Token 即一个节点,不同节点间通过注意力进行连接。Decoder 也是一样,它建模的是目标语的图。」
% l( z( N: J2 ?" E D& X' c, T. z! d( e, a5 ~6 e$ u
2 X( C1 V3 H& `9 I
 . e% X2 p) e! h! N3 I5 p
/ B2 ?* P# q" l' p: |$ S9 Z/ ?
% V8 u8 G8 [# b6 l0 ~Smola 表示:「目标语的图是半完全的,也就是每一个词只能注意到已预测的历史词,它和原语言的完全图是不一样的。最后 Encoder 和 Decoder 相结合就能生成完整的 Transformer 图。」. L# o+ f$ W3 \+ b
' h4 D- V: t0 o4 X$ N( f+ h& m7 m9 A4 m
总体而言,听过 Smola 的演讲后,我们感觉图的应用要远比想象中多得多。像图像或文本这些一般神经网络能很好处理的数据,图神经网络同样也可以,甚至计算上有更好的优势。. T4 Z) G/ E+ ?# n9 E+ Z
* |: }) x( Q9 s7 I; }
9 w; a0 ~* e% v: X# d- m, P百度吴甜:语言与知识技术产业应用创新与实践 9 C, I+ J7 b4 o1 v7 f. @' I& T
1 m S& x* a, z" t) L% O
! O8 R' h2 _9 X4 E, o0 n. X. `( i
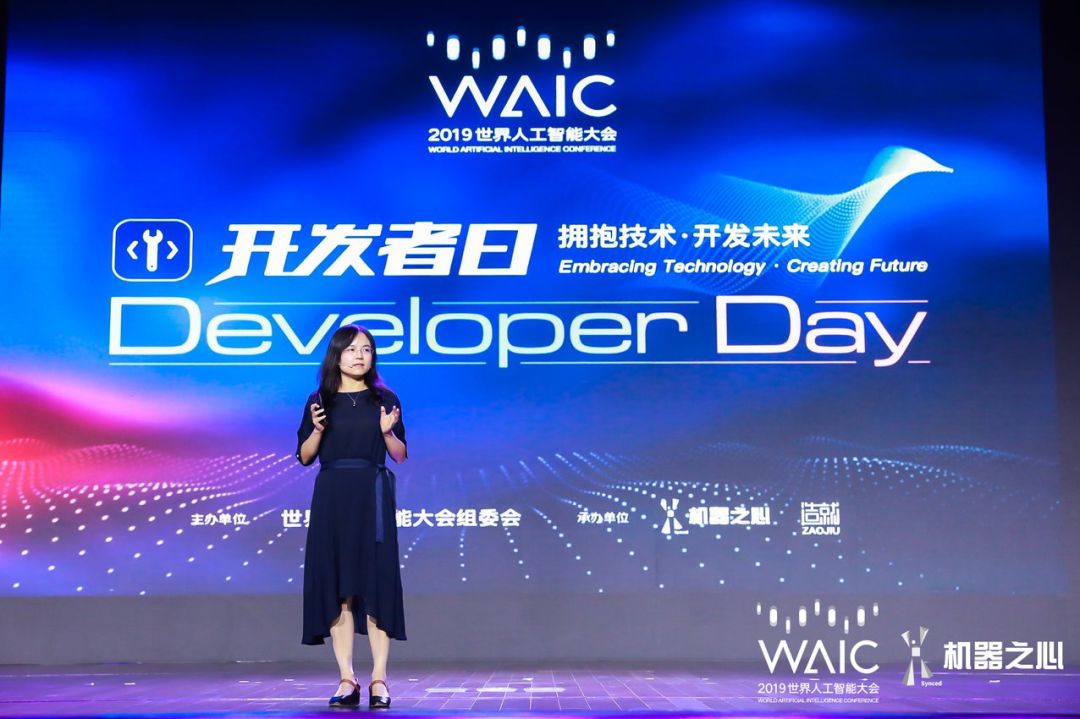
以技术落地为落脚点,在本次 WAIC 开发者日上,百度 AI 技术平台体系执行总监吴甜为我们带来了主题为《语言与知识技术产业应用创新与实践》的演讲。
/ Q K) R9 U3 f- v
8 N( e9 ^# j; V @8 J7 X# S! S0 q* H2 W% a# p* P
 + Z, x/ e$ r# C
7 C }8 ?7 I: W, V7 V. ?3 b n: D6 G: C7 f9 N( w( c% a. i: {
吴甜现为百度 AI 技术平台体系执行总监以及深度学习技术与应用国家工程实验室副主任。她主要负责百度自然语言处理、知识图谱、深度学习技术平台飞桨(PaddlePadddle)、百度大脑开放平台与生态等。
+ R D. C, b9 V1 f' S
# e7 N2 M: \3 U* ^: a" D( h/ D6 u5 P$ z; z
百度语言与知识技术布局、发展历程和开放场景
3 |' e3 T" m+ ]3 l. ?4 k2 e' o5 z
# L5 |: n6 T2 [
5 G w% g Q2 R' \$ q) Y吴甜开始逐一介绍百度语言与知识技术布局,其中底层的知识图谱是基础,中间层是语言理解和语言生成,最上层则是智能搜索、深度问答、对话系统、智能创作和机器翻译五个应用领域。
+ b4 L2 K+ i: q) A& n/ c& J+ J; `# d7 s$ p
- p# I1 s9 ~: I% V% K& C7 m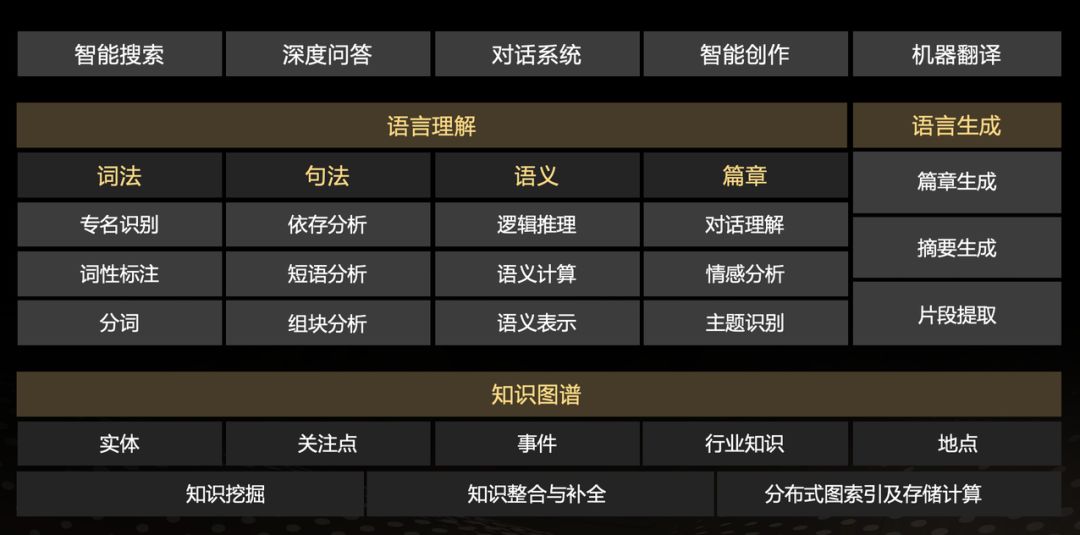 9 U% O' f# y1 l" [) p
百度语言与知识技术布局。 * S0 }+ X* P9 I& F( d ~
* z4 c7 c9 r4 M8 V- l$ A) {" l6 q( b0 |; e% L' J
这样完善的布局,它的发展也是有一些过程的,吴甜表示主要可以分为三个阶段:第一阶段始于 2000 年,主要集中于技术模块的集成;第二阶段始于 2014 年,开始将技术平台化;第三阶段始于 2017 年,开始开源开放大生产平台。: p7 e4 ^, l1 x
4 ~* C) T5 [+ G0 Z+ Z, c4 H
: _+ u% F0 I% K; |; h) _
那么百度大脑语言与知识技术开放全景究竟是怎样的呢?如下图所示,最底层是深度学习开源框架和平台 PaddlePaddle,倒数第二层是语言和知识领域的各项基础技术,往上是四个应用级平台,再往上是四种服务方式和各种场景方案。3 r7 d% `- t# B
# T" F% A7 V( q" t5 G
: l5 I- D* h5 ?, \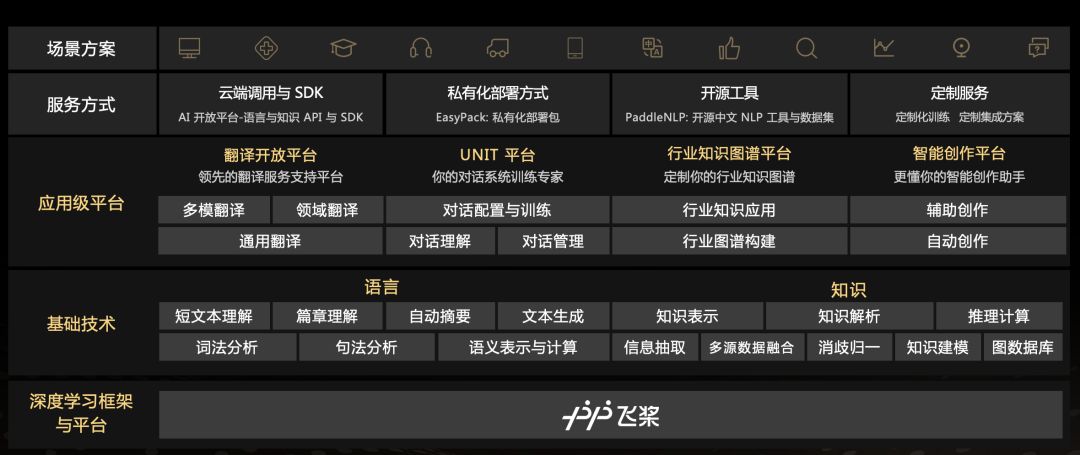
- H0 N0 v; p5 b百度大脑语言与知识技术开放全景。
- r- d- Q2 L V+ k0 M; c+ M# B; a4 f6 V# y5 z
; d: k" t9 I5 K/ d" C: Y) H# w百度在 NLP 又有什么样的重要成果?) C' B2 H" |3 k8 o3 K: w1 @; O9 w. V
/ ?' ]4 j7 e$ s! Z
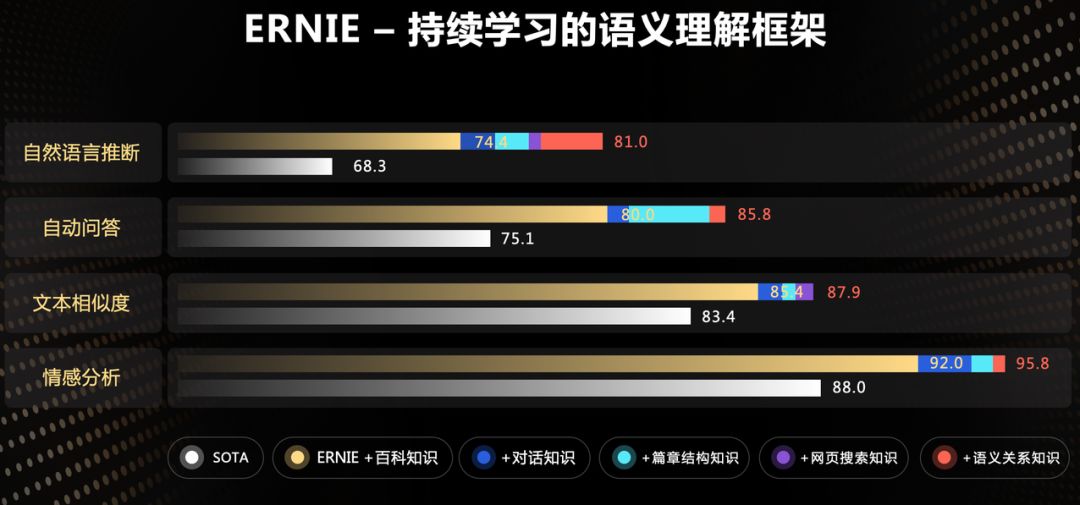
+ i- Q9 m. J! \' t6 r6 Y/ m9 T百度在自然语言处理领域的重要成果包括语义表示预训练模型和今年 7 月份推出的持续学习语义理解框架 ERNIE。吴甜表示,ERNIT 已经累积了 13 亿+知识,其中包括 1500 万篇百科语料和词语实体知识、10 亿条网页搜索知识、700 万轮人类对话数据、2000 万对句子语义关系和 3 亿组篇章结构关系。
2 ]3 K7 {, Z' [
) M$ O% ?: \4 Y4 j x! _6 O4 e |2 J, P8 O8 e8 @, Z: j9 c
 9 P; R' y, O" }
持续学习的语义理解框架 ERNIE。
3 ~- T8 U+ W* U8 t/ T6 u8 {& T3 Z9 R( q) h5 _
$ F3 ]8 l& I1 H9 O9 C( C
ERNIE 框架在工业应用上又有哪些效果呢?首先在智能问答场景中,如果将 ERNIE 模型应用于问题的分析和排序上,召回率就能提升了 7%;在加入 ERNIE 模型的情况下,广告的相关性也提升了 2.7%;ERNIE 模型能够使文本润色的准确率提升 7.3%;在对话理解场景中,ERNIE 模型将准确率也提升了 2%。
9 D, t1 f9 b+ E: s3 ^; v2 W7 B# i# D4 l/ _; v* P
+ }" X) q8 v$ w0 O5 mPaddlePaddle 深度学习平台8 O+ V5 o y4 T6 G P! ]4 U4 x
. _( F+ B6 H7 C+ v/ \' f) Z2 T8 l
但是要训练 ERNIE 这样的大模型,非常重要的一点就是提升训练速度。因此,百度推出了基于 PaddlePaddle 的 GPU 多机多卡训练加速,从而使得基于飞桨训练 ERNIE 模型多机加速比达到 77%。
5 A$ u4 l& ]$ [# w
! s, F& j8 D, ?! `; l# W
& X% ?! y7 j& y& p- w; x8 J! FPaddlePaddle 以深度学习框架为核心,从数据预处理到模型部署为深度学习的整个开发和应用流程提供了完整的工具。其中核心框架是从头构建模型的基础,而工具组建可以帮助我们快速训练与试验模型。最后的服务平台会为开发者提供整体流程支持。& J. ^- l' e, U8 O8 \
- F' |" M9 f8 X. s: T2 S
/ B/ T& S: v8 m2 N' w/ j, w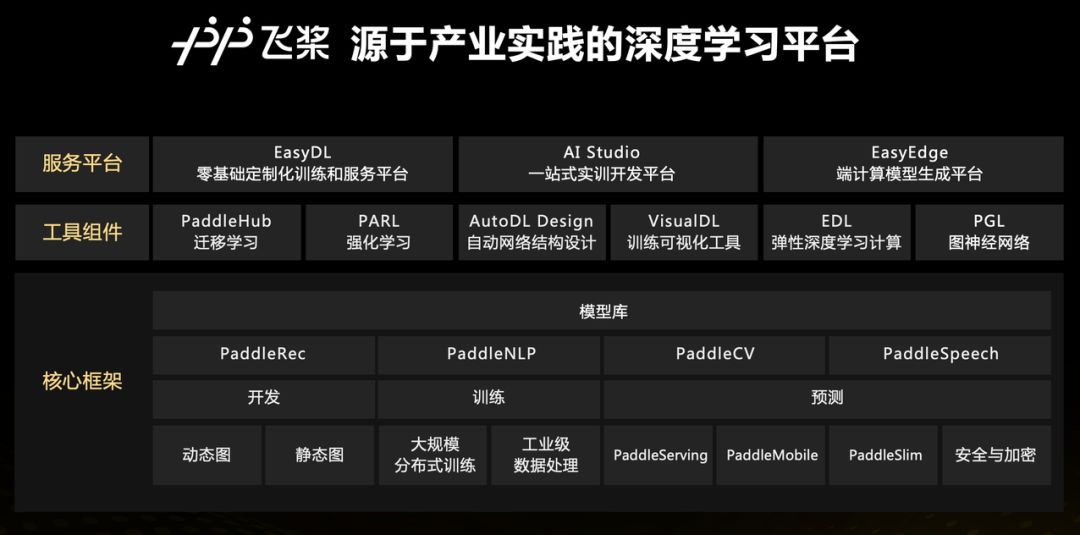
7 A; h1 C5 V4 s
" C5 a3 y; R* h$ O2 ^
. Z0 a( X. k# V吴甜后面分别介绍了一键加载工业级预训练模型百度 PaddleHub 和面向工业应用的中文 NLP 开源数据集 PaddleNLP,后者提供共享工业级骨干代码,能够轻松适应领域需求。它们都是以飞桨为核心框架,并扩展它的能力。- N) M9 Z% _9 D8 K
) o6 S9 |" r2 f( t- h3 d6 Q7 C9 e: f" B1 P4 L+ o
在 DL 平台和基础技术之上,吴甜以 UNIT(理解与交互技术)平台为例,介绍了应用级平台智能便捷性。UNIT 平台致力于打造为对话系统定制的专业、低成本、全链路的技术与服务平台,并已经为金融、教育等行业提供解决方案和服务。( B4 A% C9 |: `/ K
' N- Q5 D, V3 C, Q4 Y/ U
3 ]7 H h" J/ g4 k# Z$ NUNIT 平台核心技术包括语义理解、阅读理解和对话管理三大部分,其中 ERNIE SLU 可达到在同样理解精度下标注量降低 37%~72%,DataKit 可使数据生产效率提升 8 倍,使用语义理解 SLU 定制可使对话技能综合研发成本降低 60%。目前,UNIT 平台已实现 6.8 万定制技能,累计交互次数达 570 亿次,全面覆盖智能客服、智能出行、智能办公及其他智能交互场景,为一线开发者实现 AI 产业化提供有力工具。! A4 K7 F4 p) @1 @9 n
P$ i+ ~+ A& D. E$ D
$ g8 V: q2 | i0 o' T: r% C
总体而言,百度的语言与知识技术就是在飞桨深度学习平台上,搭建完善基础技术和应用平台,从而构建更强大的 AI 基础设施。
' |( j$ h1 y, g- U$ ~: `- `1 O3 U$ {2 q. {
% s! ~% M' S" k# \
Julia 创始人 Viral B. Shah :天生支持可微分编程的 Julia ( C$ A6 ^3 V7 r1 [6 A, Y
6 S* u) w$ A+ k- e! _; E7 h1 P1 b- [; \, T2 u+ K
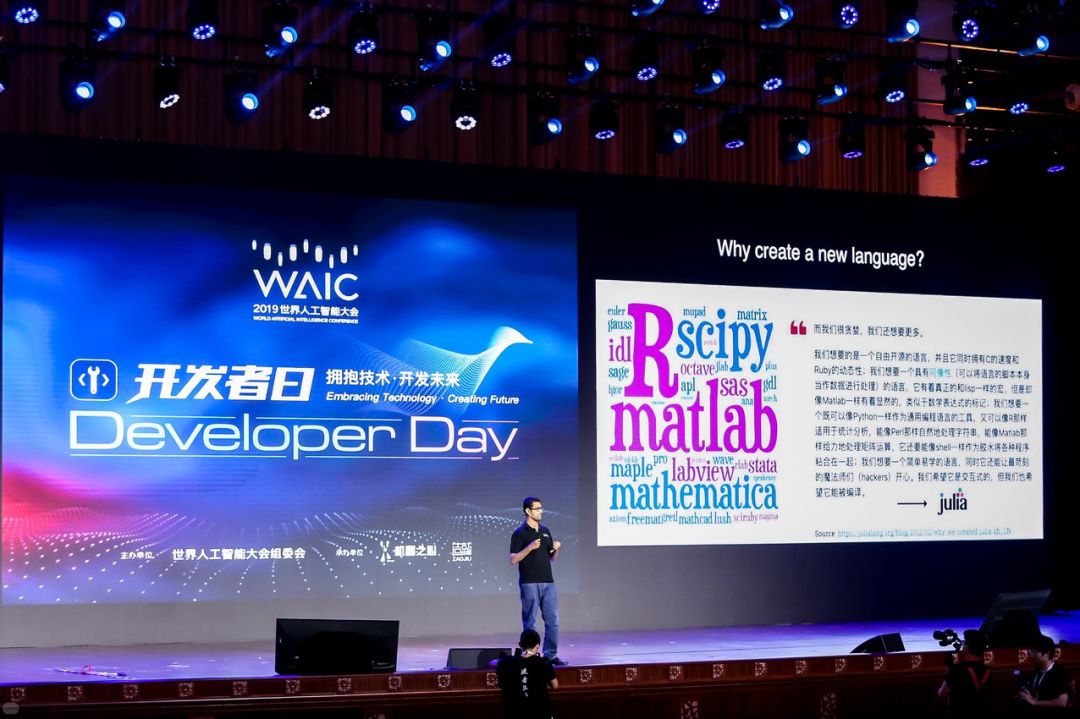
去年 8 月份,MIT 正式发布了 Julia 1.0,在开发者社区引起了很大的轰动。该语言旨在结合 C 的速度、Matlab 的数学表征、Python 的通用编程与 Shell 的胶水命令行。那么,Julia 语言以后该怎样走?Viral 在开发者日表示,只有内嵌可微编程系统,Julia 才能更适合深度学习开发,适合更广的科学运算。
3 P; t, d! H5 U' m
5 ^' ?5 L. Q- S4 [7 [+ q T, I9 v/ B( ]+ O# v# s
 8 m, d# G y; T: q+ E
. s0 m8 a6 m# h9 m4 A
# X$ f# O/ u" K- d( I' H在本次的开发者日上,作为 Julia 创始人之一的 Viral B. Shah 博士重点介绍了为什么 Julia 适合做机器学习开发,以及 Julia 在科学计算与机器学习上的可微分编程探索。这种机制将内嵌于 Julia 语言,且因为没有中间语言的转换,它做深度学习、做反向传播的速度还要快于 DL 框架。. \2 g+ V, ~/ z, _7 h1 z* f
% O/ H9 J- a6 k/ T
- L+ a2 i. T( R$ A: }; BViral B. Shah 拥有加州大学圣巴巴拉分校的计算机科学博士学位。他是 Julia 语言的创始人之一、Julia Computing 的联合创始人兼首席执行官,也是开源程序 Circuitscape 的作者之一。
+ a- s6 }) G/ D) E3 x9 C# O t) `
7 L8 S* {: P! [3 {% p8 L0 r
9 H4 L) t+ q- C8 u0 S }拥有如此多的研究和开发经验,Viral 在开发者日介绍的《Julia: Generalizing Deep Learning and AI with Differentiable Programming》一定很有意思。
& l0 G7 I4 Z! w% G2 o. e* f- D( p6 U1 j; a; N" n$ e/ L
+ \1 R, b5 L7 P. i6 y( u
为什么 DL 需要新语言) w' O5 @) l5 g6 s
/ v/ E% a8 [& G! |/ ^
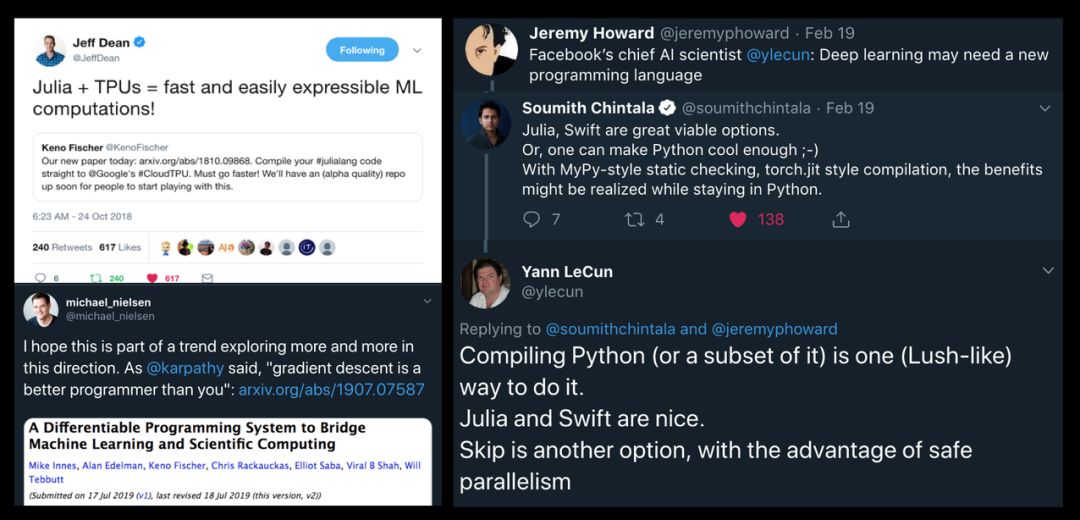
8 X: ^6 e/ O8 R1 n; ~+ ^1 I0 eJulia 在中国已经有非常成熟的社区,它的性能优势也不可忽视。Viral 通过大牛的 Twitter 展示了为什么深度学习需要一种新的编程语言,不论是出于性能上的考虑,还是出于编程模式上的考虑,一种更专注于机器学习的语言都是有必要的。这种语言应该内嵌可微分编程的思想,并提供便捷的模型 API。
3 z$ Y" q% x& f3 y* {% e. r; y @4 O2 w' l# U. J' k
) @$ s8 R, Z6 n+ y- h- Z* ~* p
% k$ n% A& w$ F( p! P, U; D3 T. y7 i' C4 o
1 Q; ^7 S h; V) h4 _0 e
Julia 的可微分编程是什么样的! |( t' W' F! ^ E* y) \; {
% O5 H2 z% I* W# H+ ~6 A8 g& \. x# C) `# L) Y {
Viral 说:「我们最近也发过相关论文,尝试建立机器学习与科学计算之间的桥梁。这个名为 Zygote 地可微分编程模块将内嵌于 Julia 语言,并作为第一等的特性。可微编程最重要的特性是执行 source-to-source 的转换,自动微分转换基本上没有运行时开销,因此它要比反向传播的实际计算成本低很多。」
0 F3 F$ e/ {. w3 P# h' u
6 o; C; H* |# c$ w7 x& s( ?* E+ i- I0 q) |+ G" ?- A( e% n
如下所示 Viral 介绍了可微分编程与一般的编程有什么不同。
9 Q5 f1 H+ h# E+ s7 ?$ U
# E$ D4 `& {# r2 k2 k
+ A( ~. h! g% z, i8 v4 t* l( {2 d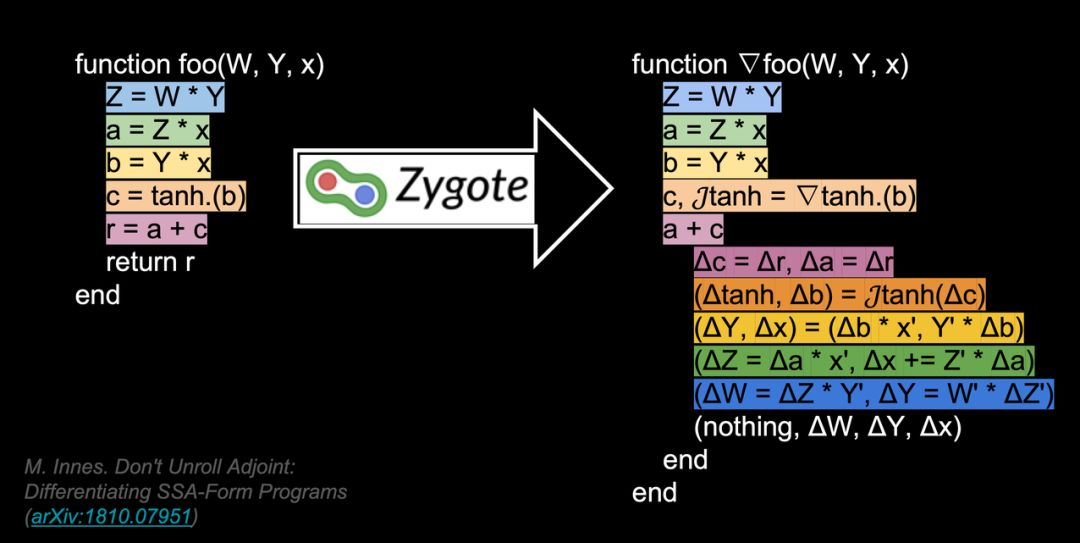 6 V% o+ u' | L5 y9 U" R
* v/ L2 ^ N2 v! z5 X
& _. a& D1 z) u5 IViral 表示:「Zygote 可以对任何函数进行数值计算与梯度计算,只要我们如平常那样定义了函数或高级函数,那么 Julia 和编译器就能自动算出梯度。这种梯度可以用于进一步的运算,例如反向传播或梯度下降等。」这是 Julia 非常重要的一个特性,它能处理更广泛的任务,例如应用物理学或分子生物学等。" O1 ?( e1 g1 ?! ?
. ]4 U6 j' L- j5 ? q
" L P" u$ [: o* b2 X「不止机器学习,其它广大领域的科学计算也需要利用这种可微分编程的优势。因为它们之间有很多相似的地方,例如都会使用最速下降、拟牛顿法等基于梯度的方法,都依赖线性代数等等。」,Viral 强调到。
$ G2 M2 D7 l; n0 O, ^ q+ @5 P+ l6 i" u# h
% g# j4 t: \6 t; T1 k后面 Viral 还介绍了 Julia 与可微分编程的众多案例,如下主要展示了微分方程的应用。, X* F/ r7 I* y1 T$ ?& Z
0 i8 F" N8 J V
* m' C" R& O6 O- w$ d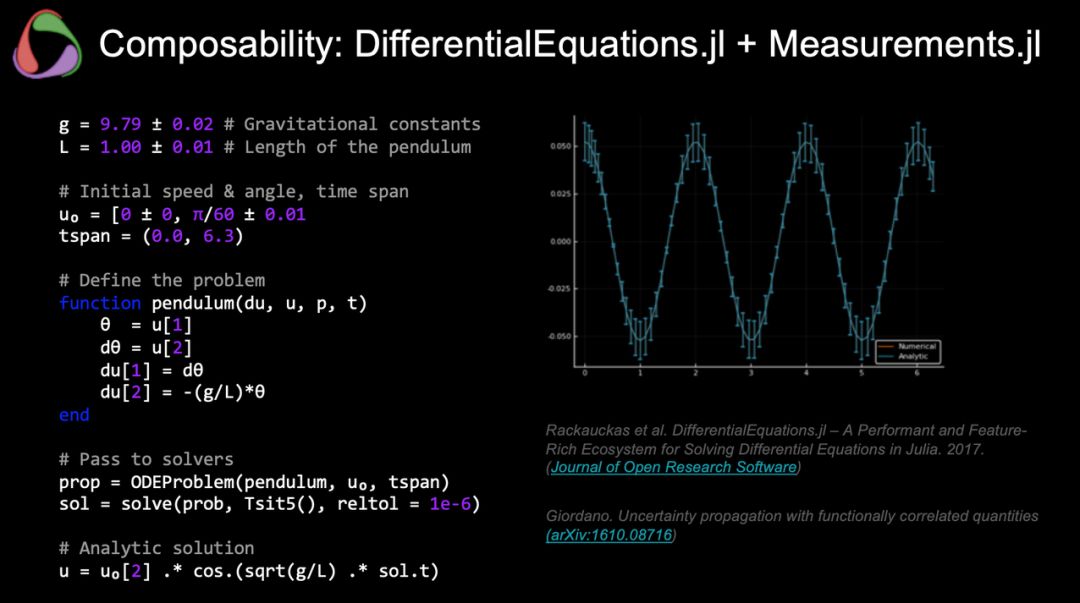 , w1 C5 r, A! P, C. Q7 {1 a* Z
8 ]! q( w1 i1 r# C+ o- U4 T7 X, d
' n" R, C' G# i3 PSkymind Adam Gibson:AI 对第四次工业革命的推动 3 s& r/ ]5 F# Y1 l
8 f% @6 v% w& t% F+ ]4 u/ I) I
* y) X% w" L- l' B1 e4 h自 18 世纪以来,人类社会先后经历了三次工业革命,从手工时代逐步过渡到蒸汽时代、电气时代和信息时代。而今,我们正在经历以基因、人工智能和清洁能源等技术为突破口的第四次工业革命。其中,人工智能是推动第四次工业革命进程的一股重要力量。
- x3 Z4 ^/ b' c/ J
7 T/ F- _* z: E* r) J. t% M6 y9 t* U# K
在本次的开发者日上,美国人工智能/机器学习公司 Skymind 联合创始人兼首席科学家 Adam Gibson 做了主题为《The Driving Force behind theFourth Industrial Revolution:Emerging of AI in Industrial Applications》的演讲。5 |* A# h/ o- @% j) G/ X
* q) [( v0 n9 s! E6 ]
0 \! ^6 Y8 y* D a& W( }; o# C6 U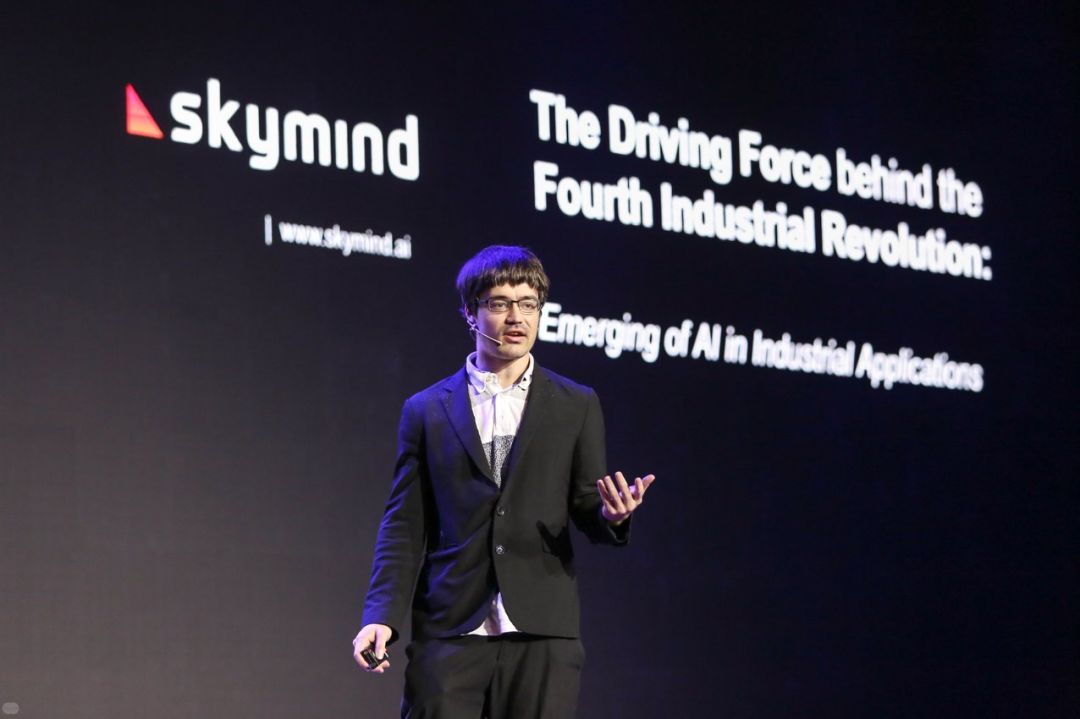
5 k' p5 G) Z( V除了创建 Skymind 之外,Adam Gibson 还是最广泛使用的开源机器学习库 Eclipse Deeplearning4j 的创建者以及旧金山 Galvanize 技术学校数据科学硕士课程的顾问。 - g- N7 q( i5 `& b6 u
' E5 j2 n" \6 R8 I. c r
5 ?' T! M# |) V' z& q& C: dAdam Gibson 在演讲中指出,维护、维修、人机合作、生成式设计、供应链、产品优化、网络安全等都是工业 4.0 时代的推动力量。
& g9 f0 n& D5 n6 T" a3 o0 G3 F
& l; S- q9 j/ h( ?7 N; e6 V" q; g5 v' b _1 E4 N; F& U
企业中的 AI 应用现状
, Q8 d v' {$ x. U$ G3 |) G. j$ f0 @9 B
$ n( b. v3 T4 z# `9 L# H* V2 S+ t; G, i
既然工业 4.0 的实现离不开 AI,那么 AI 在企业中的应用现状如何呢?Adam 指出,目前全球通过 AI 获取价值的企业还不到 5%,而且这 5% 的企业对 AI 的利用也大多不够充分。其中有些中小企业只是听说过 AI,但没有人才或资金来帮助实现 AI 的利用,还有些大公司声称自己用到了 AI,其实用的只是上世纪 80 年代的认知系统。只有极少数 500 强公司或顶尖科技公司才能足够的人才、资金利用先进的 AI 系统,并利用其产生价值。
, ]) E6 K! z4 r% ?" [3 g5 g) _( h+ H, ~5 s( e
5 I8 L) R( I7 ^' M6 T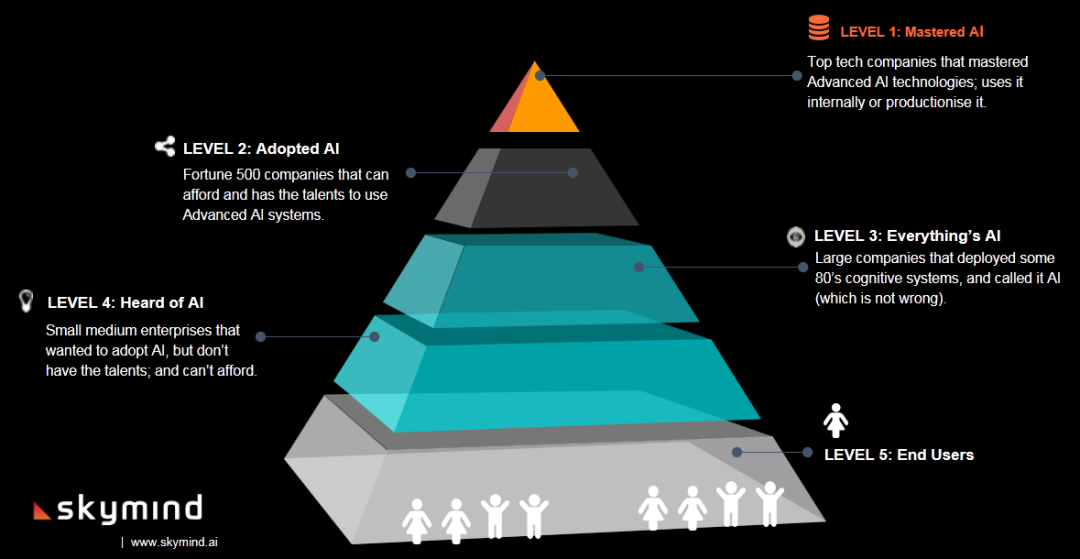
! @* k% p4 f5 w0 D! |' q0 {- X5 {3 L5 O( x
, k: |( O$ {4 q9 e0 B& } 此外,Adam 还指出,我们现在要做的就是降低 AI 的应用门槛,通过多样化的处理将学术研究成果转化为更加实用的现实应用。同时,我们还需要看到市场需求所在,还很多论文忽略了这一点。) j2 {- C7 Z; m. ]/ C' C# B% S0 j5 C
+ t. D+ e7 b9 B$ p# {: V% ?" D( {8 A% x& g7 x9 v9 N; F! |4 T: `
如何在工业 4.0 中应用 AI?
1 i) c' e! [7 ^& \' Z) t( Q3 j( D
( ]" n# ?5 x' p/ ` Y2 O) T除了上述人才、资金等条件外,在工业场景中应用 AI 首先需要解决数据问题,因为这些实时响应的工厂都是新颖而独特的,无法提供训练 AI 模型所需的大量数据。
5 b! l3 C0 \+ D5 E+ V8 E# A# ]$ l, x1 D* Z
# z Y* i5 b1 z+ o) N对此,Adam Gibson 呈现的解决方案是将模拟与 AI 结合起来,即在模拟器中创建许多 AI 可以学习的可能场景,这也是强化学习模型的训练方式。
7 U" n$ M& ^5 l: g0 Z* q( E
- h- Z, v% `5 y; D+ H
+ T6 B/ x% H3 I1 v y0 O) x强化学习不止与 Alpha Go 有关,同时也是我们通过模拟来做机器学习的一个分支。- M' w- X0 r( W' _ g6 t; [ V
: @& Q9 i* R0 p
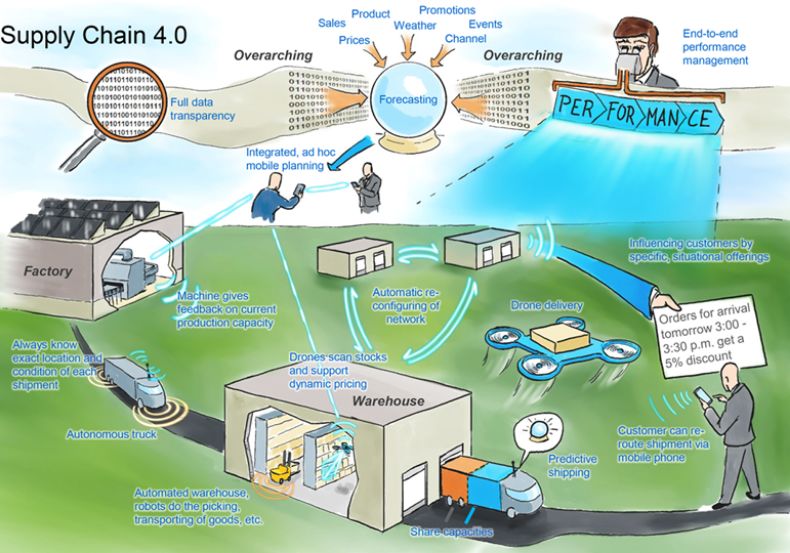
/ a8 ]' c E+ x广告商如何投放广告才能实现效益最大化?物流公司如何优化送货路线才能降低成本?从供应链、智慧交通、人机协作再到工业流程模拟,工业 4.0 时代的许多问题其实都可以归结为 NP-Hard 问题,即组合优化问题,而强化学习为这些问题提供了一个可行的解决方案。利用强化学习学到的策略可以部署到各种设备中,以自适应的方式自动完成某些任务。0 f6 t; p [) S$ v" o. z2 x
4 M* X3 y1 Y6 C
4 c* T& I+ Z( @9 D" E Z; ^
, G) H* ^( n! C* Y! y/ U9 t P: x! r' x/ C& N
7 T# M9 y) A; j0 x5 m$ G' Y/ I 此外,Adam 强调,在这些场景中,我们要打造的是一个端到端的解决方案,建造一个中心化的系统,把数据收集到一起,然后不断进行模拟、迭代。; u- {7 m" S& {- A. q
5 F/ `% m6 C4 \2 y' q
# Q. U. T2 D6 N* Q J( ?- b
以上这些都是主单元的主题演讲的精彩内容。当日的主单元还包括WAIC黑客马拉松颁奖典礼、两个圆桌论坛等精彩环节。9 Z; W1 X% Z5 A! }
' w" b# _ B9 {1 a* F0 U经过一天的高强度知识洗礼,相信大家都回味无穷,很多读者可能也都希望亲自听听大牛口中的「开发经验」都是什么样的。这里机器之心准备了重播链接,点击「阅读原文」观看整场 4 个多小时的知识盛宴。" ~( |* c9 e# a7 w; W3 A- n8 P# }
9 M$ l n) ~' ~2 H- {( {
2 w( u* ]1 R2 S# O0 |9 I& i
' E; Z% J4 O7 X9 F- U D6 Q& w* X! n: G
本文为机器之心报道,转载请联系本公众号获得授权。
& U1 f c' B, f2 T✄------------------------------------------------加入机器之心(全职记者 / 实习生):hr@jiqizhixin.com投稿或寻求报道:content@jiqizhixin.com广告 & 商务合作:bd@jiqizhixin.com K6 d6 O2 Y2 d: A1 M/ g
来源:http://mp.weixin.qq.com/s?src=11×tamp=1567326604&ver=1825&signature=e5agdBSSGq8YPKsP8BOGJpnGqq*vhv6ldkToM8IdpYozvvXc2EguqwjYOASEXKBiaECAQzjFhxZHiiHtZ30YFZnvnVHxzKCnZdPaPW15Cr1oNsjkbuc1SZkdZSDRxb6q&new=1+ o! K$ ~6 M8 N+ g! G, D
免责声明:如果侵犯了您的权益,请联系站长,我们会及时删除侵权内容,谢谢合作! |
 |手机版|小黑屋|梦想之都-俊月星空
( 粤ICP备18056059号 )|网站地图


 发表于 2019-9-1 16:49:57

