: j7 R. v* H' U m! b( R
市场被催熟,巨头进场收割。
/ a6 J: J; f& `6 d边缘智能,人工智能的最后一公里,很长一段时间里被创业者视为得以绕开巨头打压的蓝海市场,在今年开始有了微妙的变化。
; q1 Z3 J6 s1 J: x2 R% j$ h& x1 S& V- d e
( }2 S( B1 p% N撰文 | 四月、力琴感谢机器之心海外记者袁渊提供相关资料
) c' d, m" Q0 n$ d! s11 月 13 日机器之心消息,北京时间今日凌晨 2 点,英特尔在旧金山举行 2019 人工智能峰会,推出从边缘到云端到全新 AI 芯片,包括下一代英特尔 Movidius Myriad 视觉处理单元 (VPU),用于边缘媒体、计算机视觉和推理应用,以及难产三年终于落地的 Nervana 系列,面向训练 (NNP-T1000) 和面向推理 (NNP-I1000) 的 Nervana 神经网络处理器 (NNP)。
, |/ Q* p2 P$ |三条 AI 芯片产品线的发布,标志着英特尔人工智能业务获得实质进展。: R# d& Q. }( {3 c
 + L& Q8 A1 A! ?- n# ?, A
在最近的财报电话会议上,英特尔乐观地预测,2019 年人工智能的年收入达到 35 亿美元,高于 2017 年的 10 亿美元,完成 2022 年 100 亿美元目标的三分之一以上。
( `6 H" l6 B" R2 ^2 y英特尔透露,在无人机、相机、机器人和自动驾驶汽车等设备的边缘计算收入同比增长了 20%。5 o1 f1 u" A" m8 T
「这一数字将逐年增长,基于我们的广度与深度,已经从数据中心走到边缘。」英特尔公司副总裁兼 AI 产品事业部总经理 Naveen Rao 表示。% b0 {: w) L8 g' N
1
) E! V; M- T( J$ T9 v边缘端性能十倍提升7 {: Q8 |, a: P1 c7 K
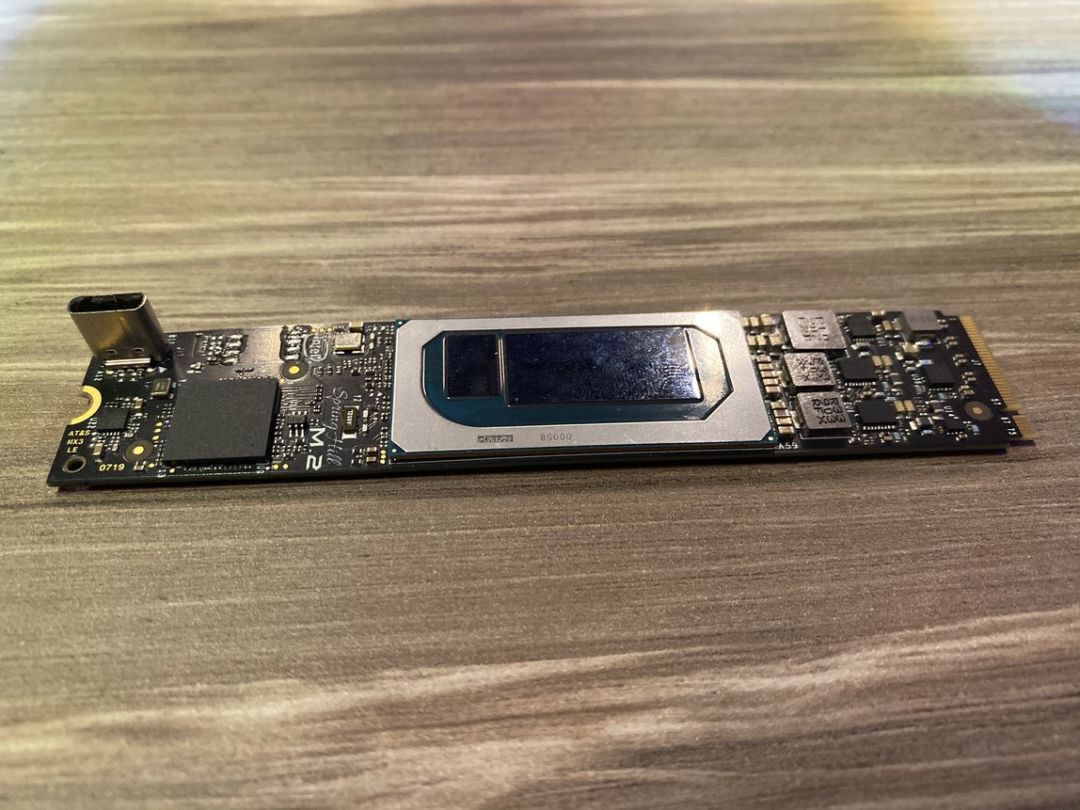
英特尔详细介绍了代号为 Keem Bay 的下一代 Movidius Myriad 视觉处理单元(VPU),该单元针对边缘推理任务进行了优化。7 M. Y/ E; W# V$ P# B
; }$ W6 T1 x7 M! L( `3 r
英特尔物联网副总裁乔纳森·巴伦(Jonathan Ballon)表示,该芯片拥有一种新的片上存储器架构,具有 64 位存储器带宽,性能是上一代产品的约 10 倍。
+ q% T! l: C, R$ y: `0 S5 x; V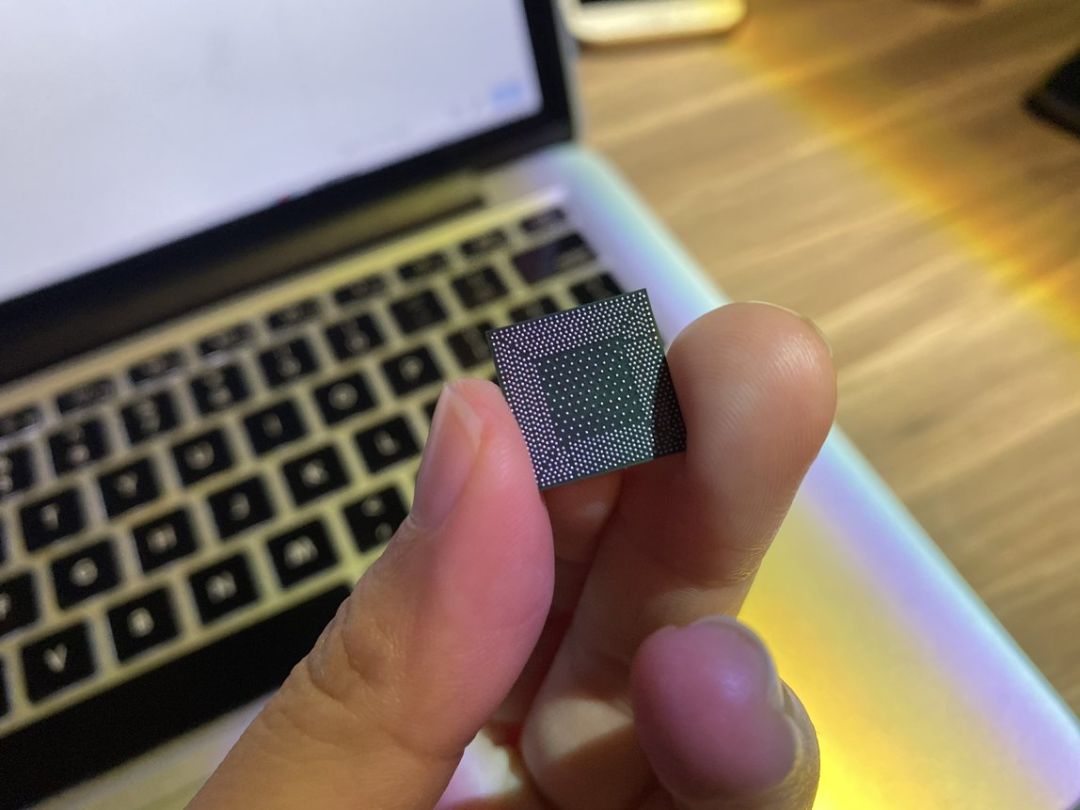 机器之心现场实拍 巴伦称:「它将以比同类产品低一倍的性能,几分之一的尺寸和成本来提供优于 GPU 的性能。」
# C4 G; h% n( B; yKeem Bay 中封装了用于计算机视觉的专用芯片和 12 个可加快运行速度的专用(SHAVE)处理器内核,可使用 Myriad Development Kit(MDK)进行编程,从而兼容更多 AI 算法。9 v2 ~$ o) ^; l. U& E7 V2 W: o
英特尔表示,Keem Bay 的功耗是 Nvidia 的 Jetson TX2 的四分之一,比华为昇腾(Ascend)310 计算速度快 1.25 倍。在特定情况下,能效比竞争对手的处理器高六倍,每秒提供的 TOPS 推理量是 Nvidia 的 Xavier 的四倍。
& O5 A! M* X8 h" Q% ~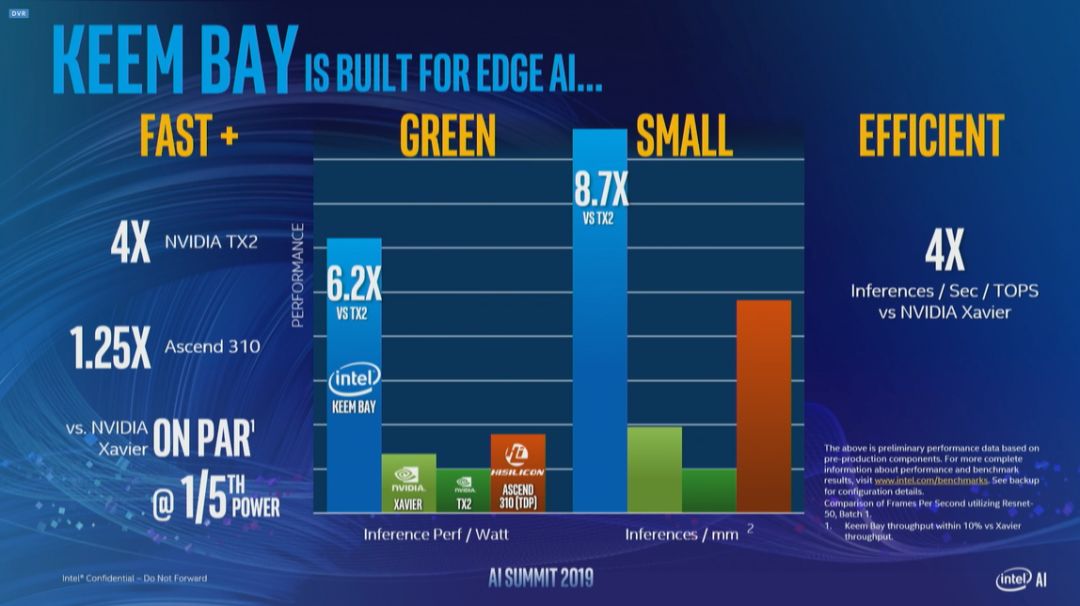
3 u) g- {3 e' F& @! \1 {+ Z3 O+ c该款芯片将在 2020 年上半年推出,包括 PCI Express 和 M.2 等形式。' |8 k/ c: P$ H' |$ ~
早在 2016 年 9 月,英特尔就收购总部位于圣马特奥的 AI 初创团队 Movidius,设计用于计算机视觉的专用低功耗处理器芯片,为其终端算力市场步下重要一子。
8 |. |7 L8 v- O# W% Y. ~! }2017 年,英特尔推出 Myriad 2,被 Google 的 Clips 相机,大疆的 Phantom 4 无人机,和国内安防市场的高端摄像头所采用。2 @' E) {- C( v6 s2 Y! d
随后推出的 Myriad X 具有改进的成像和视觉引擎,包括附加的可编程 SHAVE 内核和升级的视觉加速器,以及支持多达 8 个高清传感器的本地 4K 图像处理器管线。5 s& e$ R ^' a! @
参考英伟达在软件生态的深厚基础而能厚积薄发,这次巴伦也着重强调了,英特尔在软件与开发工具方面的努力,使用英特尔OpenVINO 工具包的客户可以获得大约 50%的额外性能。& \3 q% Q& t/ L6 y J( R1 g
基于 OpenVINO 工具包,Edge AI DevCloud 能够对无人机和摄像头等边缘设备进行 AI 原型和测试,开发人员可以使用现有工具和框架免费测试和优化 OpenVINO 中用于 Intel 硬件(例如 CPU 或 FPGA)的模型。
: d( p- \8 W$ g) Z7 S随着 Edge AI DevCloud 的发布,客户现在能够使用在夏季推出的 Deep Learning Workbench 工具进行建模和仿真,然后将其免费部署在开发云中的各种不同硬件配置上。
# ]3 s: z' V4 t @Ballon 在与 VentureBeat 的一次对话中称,OpenVINO 是英特尔历史上增长最快的工具。# D y2 X. v# k( p
2018 年 5 月,英特尔首次向开发人员和制造商提供 OpenVINO 或开放式视觉推理和神经网络优化,以使用英特尔硬件进行深度学习推理。
+ G5 T6 J+ l# a) d1 MOpenVINO 支持从 CPU,GPU 和 FPGA 到 Intel Movidius 神经计算棒的一系列机器学习加速器。该工具包于今年早些时候进行了更新,以扩展到计算机视觉应用之外,并支持语音和 NLP 模型。
# l/ Y1 N- |) ~" g: Y; \英特尔今天还与 Udacity 一起推出用于物联网纳米级程序的 Edge AI。据悉,正在创建的数据中有 70%位于边缘,只有一半将进入公共云,其余的将在边缘存储和处理。; a3 p7 d6 v% S1 ~0 T
2! u! N' G+ z$ R' {. M O' @
云端AI芯片终商用# z( O) |6 A* S
在终端之外,英特尔当然没忘最核心的数据中心市场,Nervana 产品线难产三年终于落地。% f- p2 y/ I4 ]: H1 n. D
! U; j* u. F+ m8 d) b' O
英特尔推出面向 AI 推理和 AI 训练领域的两个系列产品,分别是神经网络训练处理器(Intel Nervana NNP-T)和神经网络推理处理器(Intel Nervana NNP-I),作为英特尔为云端和数据中心客户提供的首个针对复杂深度学习的专用 ASIC 芯片。0 P7 K5 G9 \% ]: O
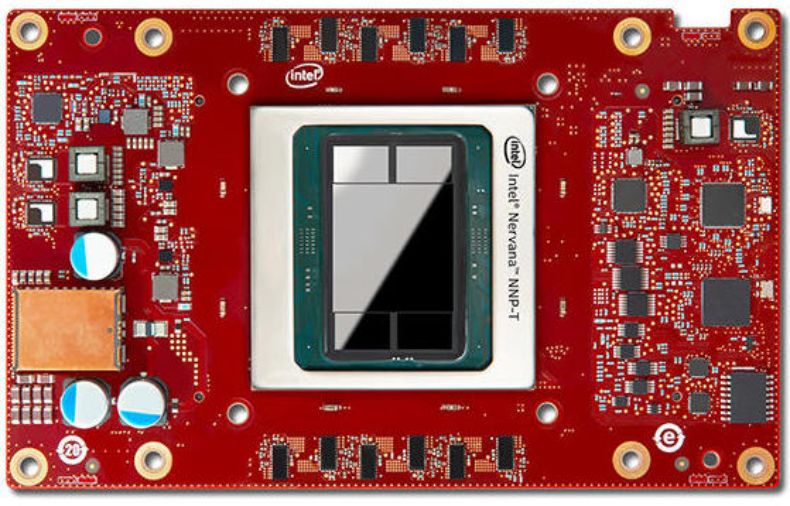
2 y1 g/ h b4 ?: C/ ]$ B7 H2 z训练芯片 NNP-T 采用台积电 16nm 制程工艺,拥有 270 亿个晶体管,硅片总面积达 680 平方毫米,支持所有主流深度学习框架。$ Z+ ?! o2 y8 v6 Y2 g, w, b: B
 机器之心现场实拍推理芯片 NNP-I 基于英特尔 10nm Ice Lake 处理器架构,在 ResNet50 上的效率可达 4.8 TOPs/W,功率范围为 10W 到 50W 之间,同样支持所有的主流深度学习框架。早在 2016 年,英特尔就提出启动 Nervana 神经网络处理器的项目研发,直到今年才正式揭晓,并宣告正式投入生产,并实现商用。* l* e2 ^* p" [5 W5 i/ D2 R
值得注意的是,这两款产品面向百度、 Facebook 等前沿人工智能客户,并针对这些企业的 AI 处理需求进行定制开发。3 _! F1 {5 ]* i9 S. E
谈到英特尔Nervana的独特性和优势时,英特尔公司人工智能产品事业部副总裁、推理产品事业部总经理Gadi Singer向机器之心表示,主要集中在功效、功能、规模化三个方面。
2 H2 J9 I0 k1 M- K$ Y9 D; A/ z6 v9 R; e3 ]) ~
- 1)在功效方面,Nervana提供了非常节能的构建模块(building blocks),大概能提供10到15瓦的解决方案,可以单独使用,也可以基于需求将多个模块集成。因此无论大小,都能满足用户在任何级别上构建解决方案。, H8 _+ }! L' Q
- 2)多功能性。不同于市面上的图像或语音单功能处理器,Nervana的立项之初就是必须支持多种用途。通过构建一组深度学习的功能,可以被应用多个不同类型的机器学习任务中。& n N& V8 `' [' k7 m* C: U' M7 R4 f
因为在大型云服务应用某些内容时,需要以多种形式使用它,因此需要在广泛的范围内提供良好的解决方案。# o+ @# B7 @. v( y
深度学习变化得如此之快,AI从某个研究实验室到或公司开始注意到开发再到部署可能只需要不到一年的时间,就好比去年BERT出来时, 三个月内大家对它进行了广泛的试验,一年之内对其进行了非常大规模的部署。4 g1 G: `% T* H) q j: o
在瞬息万变的环境下,研发出一个能随时‘准备就绪’的通用解决方案,我们才可以解决甚至还没有被广泛关注的新问题。因此,我们的架构是使用构建模块不断进行重组。
2 b6 f3 D. D& a# W7 N2 `% W$ l* G - 3)最后是规模化,比起硬件方面,更多组员主攻的是软件这个部分。软件对整个解决方案的优化非常关键,比如软件能了解在不同的内存位置以及使用这些功能分别需要的时长,软件能每个数据模块的使用频率并把它们放置在正确的位置上,让你可以最高效地使用推理计算引擎。
1 u2 C8 ?6 l, r, P' J. `5 K" Q; ~Nervana架构与某些单一用途的同类产品不同,使用带有接口通道的API分层构建它。最底层的API直接与硬件打交道,然后中间会有一些类似于图谱节点的API,像是深度学习图谱中的高级计算单元,然后最高层的软件层将它们映射到用户所需要的任何应用程序接口中。
8 ^1 a- z8 Z/ `7 o5 o
3 V+ x9 s o4 d- n3" Y1 u* f: j) L7 \
巨头掘力终端% }% [0 f7 z# G3 Q! \
不止于英特尔,细心观察就会发现,今年巨头发力终端和边缘端的算力市场比以往声量更大。这在某种意义上也标志着终端 AI 芯片市场的成熟,巨头开始收割。/ W3 |6 r2 S& a$ s! [9 ?
1、英伟达
7 A0 p8 Q7 m8 D7 {& HJetson 是英伟达在面向嵌入式市场的产品线,正是对标英特尔 Movidius。区别于其他边缘 SoC 的特点,Jetson 家族强调并行运行多个神经网络。
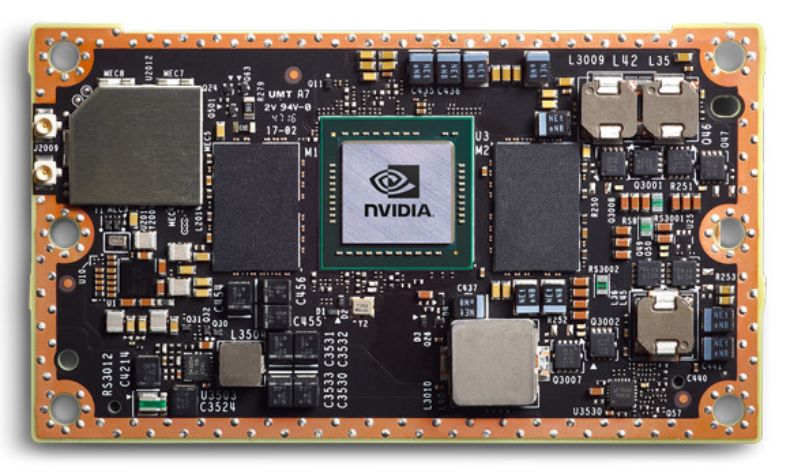
( j# R9 }2 x( t1 {: M# x0 h截至目前,Jetson 已发布四个系列,包括 Jetson TX1、Jetson TX2、Jetson Nano、Jetson Xavier NX,主要部署在边缘与终端应用上,适用于机器人、无人机和智能摄像头等应用。% G6 `9 K; b; q- B' {8 w
 1 W4 e) X1 R6 n" c( C, l
2017 年,英伟达推出首款采用 Pascal GPU 架构(16 nm 工艺)的芯片 Jetson TX2,大小相当于一张信用卡。官方给出的数据显示,TX2 可在 MAX Q、MAX P 两种状态下运行,功耗在 7.5W-5W。
5 Z/ j4 m4 s+ a: }+ m% S2018 年,英伟达发布 Jetson 系统级模块——AGX Xavier,可提供工作站级别的任务执行性能。AGX Xavier 有 10W/15W/30W 三种选择,神经网络运算输出为 32TOPS,可应付多达四路的 HEFC 4K 、60fps 视频流。# S( `7 k/ b1 t
而就在上周,英伟达进一步推出 Jetson 的最新成员 Jetson Xavier NX,号称「全球最小边缘超算」。
/ C1 w! b6 e3 X! `9 J7 e0 C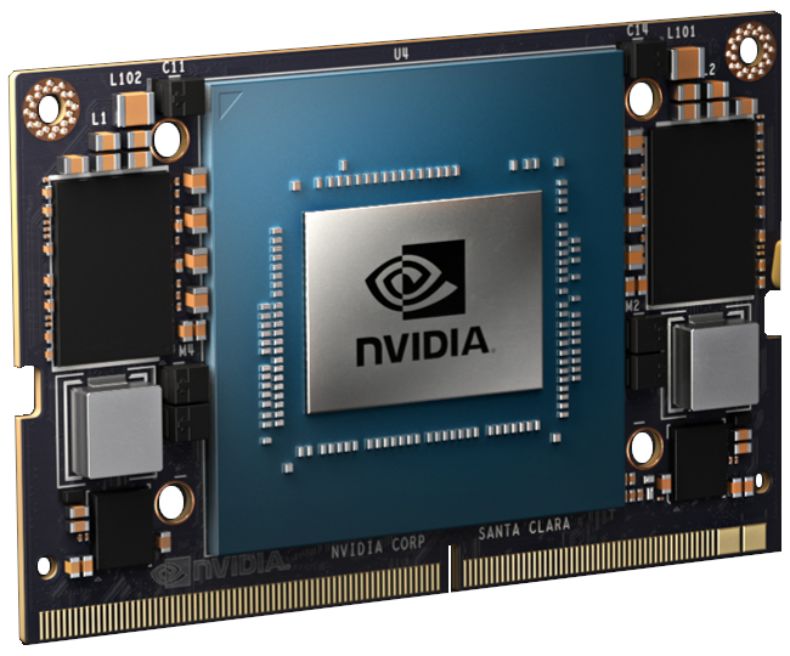
) `% g8 i& {, C2 H' Z) e9 w* }/ D可提供高达 14 TOPS(功耗为 10W 时)或 21 TOPS(功耗为 15W 时)的性能,能够并行运行多个神经网络,并在与 Nano 同样尺寸(70x45mm)的小巧外形中同时处理来自多个高分辨率传感器的数据。 S% u/ n8 _7 N
Xavier NX 将于明年 3 月开始发售,价格 399 美元。
8 |$ r+ b% f" X% d1 m与此同时,英伟达为 Jetson 配置了一套开放式平台和完整的 AI 软件堆栈 JetPack SDK,可以运行复杂的 AI 网络,并用于深度学习的加速库以及计算机视觉、计算机图形、多媒体等。! }' c: q0 Q2 Q
2、谷歌
& z& M! }# k! P# {# S今年年早些时候,谷歌推出名为 Coral 的本地终端 AI 平台,是 TPU 的边缘芯片版本,强调以低功耗水平提高出色的 ML 推理性能。能够以良好的功率表现执行 MobileNet v2 等最先进的移动视觉模型,且 fps 可达 100 以上。
% k9 L4 n% W% `4 d* z0 Y/ z9 c$ T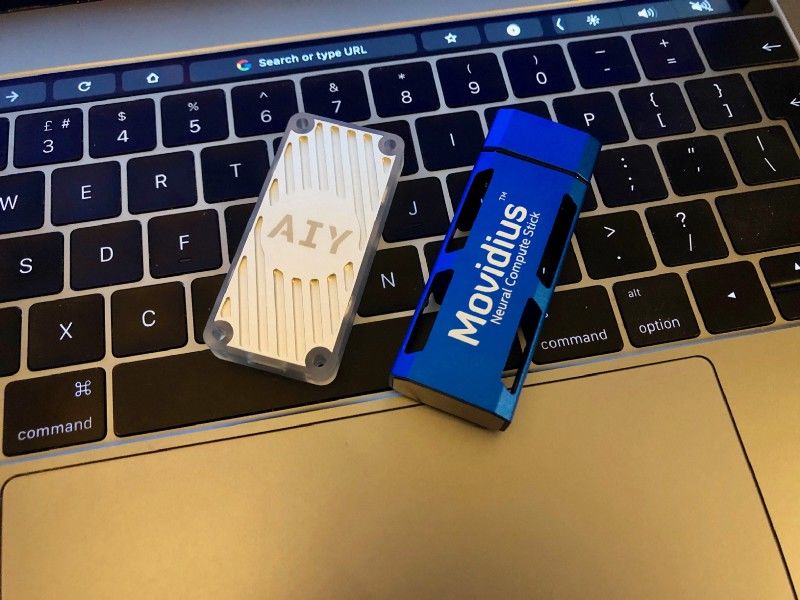 Coral USB 加速棒(图左)与第一代英特尔神经计算棒(图右)。基于 Corel 平台,谷歌发布了五款设备,分别是单板计算机「Coral Dev Board」、支持 Raspberry Pi 或 Debian Linux 计算机的 USB 加速器、对应 Dev Board 的 500 万像素镜头模块、 Dev Board 的系统模块(SoM),和轻易将机器学习加速器 Edge TPU 与现有计算机系统整合的 PCI-E 加速器。3、华为# U& O' `$ K5 M, G" `
看国内市场,当属华为作为风向标。
: y6 Q% a: y: e$ n# K) x( z去年,华为发布全面自研芯片信号,昇腾则是其推出的首款面向边缘计算品牌,采用华为自有的达芬奇架构(12nm 工艺),使用华为自有的高效灵活 CISC 指令集。! {8 D& ~. ~ h" P5 V1 H6 _ U+ r! Z
昇腾系列除了瞄准机器人、智能制造等终端智能产品,同时也是华为在安防智能摄像头和边缘计算的重要布局。+ v1 h: a+ Y! f% Z
昇腾 310 最大功耗为 8W,半精度(FP16)运算能力 8TFLOPS,整数精度(INT8)16TOPS,支持 16 通道全高清视频解码(H.264/265)。在今年上半年正式推出。
# R4 e" _$ j7 V- I5 o4- Q4 H; p" c# G' b) m6 U9 g& w5 \9 R
AI芯片创业压力加剧/ t4 u% E/ ^- B- ?, z% F9 t
很长一段时间里,由于云端 AI 芯片市场被集中垄断,同时更加依赖生态,导致大部分 AI 芯片的初创公司都将目标瞄准在边缘和终端市场,以各种 AI 加速器或 SoC 芯片的形式走向市场。/ K; u; X% x1 z& A% O
, K* w. Y2 V3 K: o# N% L0 ~
通过独特的架构设计以及领先的性能指标的芯片,以求在分散而潜力巨大的物联网市场分得一杯羹。
y6 A" a' U5 W9 k- w$ t" ]如今,英特尔 Myriad Keem Bay、英伟达 Jetson Xavier NX 的推出不仅标志着巨头边缘端 AI 芯片布局的完善和实力的进一步增强,同时也是边缘端芯片市场竞争更加激烈的强烈信号。
" Y( J2 [( [3 B巨头的 AI 芯片触角蔓延至边缘端,将让 AI 芯片初创公司面临着更加严峻的生存挑战。 : [" K5 v0 h7 w. R! z- q- N
机器之心Pro/ @/ a9 \1 t) c
追动态 | 查数据 | 找资源 | 读报告 | 做调研
" n2 I& k- O) p1 i& n) i
( G9 K/ F& a/ g5 [1 A6 h
0 m0 }# J3 t L/ _3 p机器之心Pro 是基于「机器之心团队构建的百万级规模人工智能知识图谱及结构化数据库」搭建的人工智能领域专业信息平台。, z6 i f3 b& z+ S; a) D- J
; |! L0 S3 b& y. Y* S |
8 T; E+ b1 k" z& _) T3 K) k目前已上线五个模块:dashboard、新闻数据库、行业数据库、人工智能知识库和深度精选,覆盖 38 个技术领域及 55 个智能应用领域。/ \& {/ ^( M3 r) T: ^
+ R2 p3 Z2 |- W1 W& ~$ b
8 S' e/ b7 D# o2 F" d, M+ @( R$ f; u
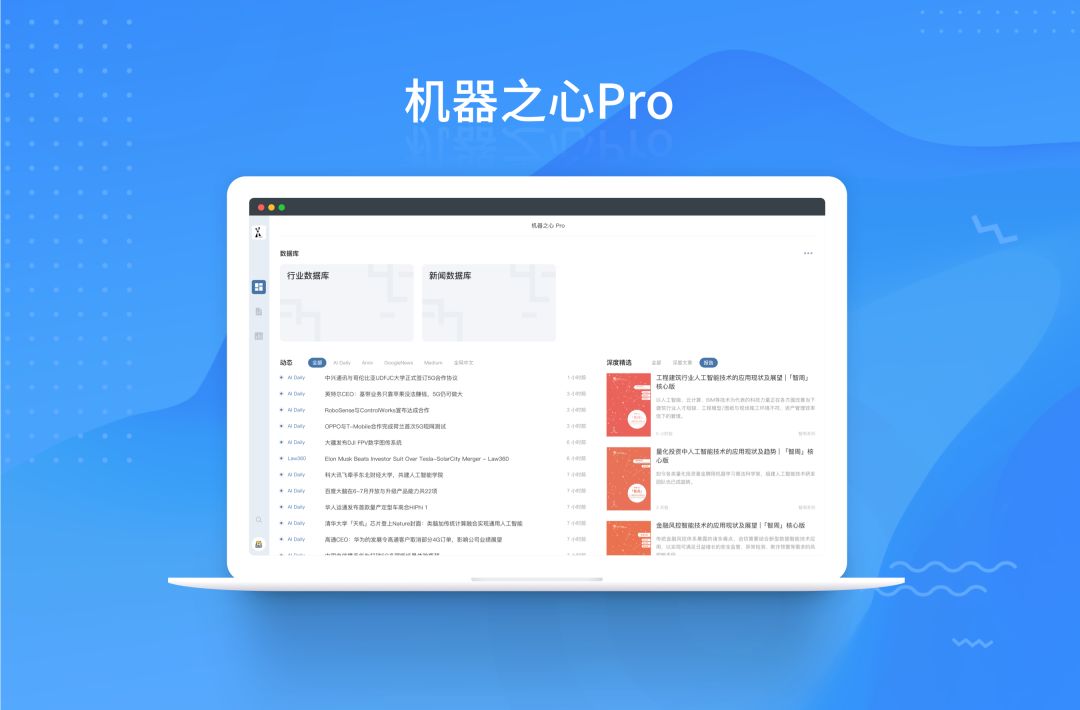
2 F& d0 Z& H5 h1 s点击图片,查看官方使用手册
! t0 S! E- @. s- ` + B" ~% S: w6 x
8 O3 p- E! ]$ e2 F$ R
i- v% ]8 V% N( |* f* t
& o& }# {* |, @; X4 p
, }! C0 K! W# Y$ x0 c8 |
pro.jiqizhixin.com
2 O& S3 j- V o, Z盯动态、找资源、做调研. {" J7 N8 r& R3 L/ W1 Y
, ?6 j3 |" ^( R0 I6 U. q3 M0 N- b1 Z$ T9 Y% T5 f
0 W, G) g: j, u4 \8 t
来源:http://mp.weixin.qq.com/s?src=11×tamp=1573628405&ver=1971&signature=T5-sAwq-3m5Q2XlXSyEJnWUzh*XzLRqDFNvi*WAAS8uu4I4H4Re6QNqwZbiN4Ovbj*Y3-E5GkoZ3ZrDQ3TQtQV6Be2aXF9hTw59p6X72-r5hzKx5ru-uIEq9FLCRlQ4t&new=1' y0 k' ?: u2 _" p& F
免责声明:如果侵犯了您的权益,请联系站长,我们会及时删除侵权内容,谢谢合作! |  |手机版|小黑屋|梦想之都-俊月星空
( 粤ICP备18056059号 )|网站地图


 发表于 2019-11-13 15:35:28

